.png?v=281638d34028)
Weekly Backlog KW 42/2026
Europas digitale Souveränität zwischen Ankündigung und Umsetzung: Open Source in München, Cloud-Abhängigkeiten, IT-Sicherheit und die Sovereign Cloud Days.
48 von 50 Einträgen
Europas digitale Souveränität zwischen Ankündigung und Umsetzung: Open Source in München, Cloud-Abhängigkeiten, IT-Sicherheit und die Sovereign Cloud Days.
Providerabhängigkeiten im Edge-Betrieb entstehen nicht allein durch die Anzahl eingesetzter Anbieter. Entscheidend sind technische Kopplungen entlang von DNS, IP-Adressierung, Routing, Security, Traffic-Verteilung und Backend-Anbindung. Eine belastbare Abhängigkeitsanalyse bewertet deshalb Wechselkosten, Kontrollpunkte und Failover-Verhalten. Die ayedo Edge Cloud bündelt diese Ebenen in einer providerunabhängig nutzbaren Edge-Plattform.
Anycast DNS ist mehr als eine alternative Verteilungsmethode für DNS-Anfragen. Als autoritativer Dienst bildet es eine eigenständige, verteilte Eingangsschicht der Edge-Architektur. Es verbessert Erreichbarkeit und Ausfallsicherheit der Namensauflösung, ersetzt jedoch weder Routing noch Loadbalancing. Diese Aufgaben müssen architektonisch getrennt betrachtet werden.
Die Integration von [Docker-Sandboxes](/kubernetes/) in GitHub Agentic Workflows ermöglicht es, KI-gestützte Codierungsagenten in einer isolierten Umgebung innerhalb von CI/CD-Pipelines auszuführen. D
In vielen Machine-Learning-Initiativen kollidieren Innovationsgeschwindigkeit und IT-Sicherheit frontal: Um schnelle Trainingsergebnisse zu erzielen, teilen sich Data Scientists, externe Dienstleister und Entwicklerteams oft pauschale Cluster-Admin-Rechte, statische API-Keys oder unzureichend isolierte Zugänge zu sensiblen Inferenz-Endpunkten. Sobald Plattformen den Sprung aus der geschützten Sandbox in den industriellen Produktivbetrieb vollziehen, verwandelt sich dieser pragmatische Wildwuchs in ein gravierendes Einfallstor für Privilegienerweiterungen und Datenlecks.
In vielen Industrie- und Fertigungsunternehmen wächst der Druck, generative KI für automatisierte Fehlerberichte, Wartungsprotokolle und Ursachenanalysen einzusetzen. Die Realität in der OT- und IT-Praxis sieht jedoch ernüchternd aus: Wer proprietäre Sensordaten, Maschinentelemetrie und Prozess-Know-how über öffentliche Hyperscaler-APIs in US-Rechenzentren schickt, riskiert den unkontrollierten Abfluss sensiblen geistigen Eigentums und eklatante Compliance-Verstöße.
In vielen Data-Science-Initiativen klafft ein tiefer Graben zwischen dem Proof-of-Concept im Jupyter Notebook und dem belastbaren Produktivbetrieb: Modelle werden isoliert trainiert, manuell in volatile Container verpackt und über fragile REST-Skripte auf Ad-hoc-Servern bereitgestellt. Das Ergebnis sind monatelange Release-Zyklen, untrennbare Abhängigkeitskonflikte und Inferenz-Pipelines, die bei den ersten echten Lastspitzen im Produktionsnetz kollabieren.
In vielen Unternehmen gleicht die Nutzung moderner Beschleuniger-Hardware einem unregulierten Wettlauf: Data Scientists reservieren vollständige High-End-GPUs wie die NVIDIA A100 oder H100 für interaktive Jupyter-Notebooks, während rechenintensive Trainingsläufe in endlosen Warteschlangen verharren. Das Ergebnis sind zweistellige Auslastungsraten bei gleichzeitig explodierenden Cloud-Budgets und unzufriedenen Entwicklerteams.
LLMOps, die Praxis des Betriebs großer Sprachmodelle, erfordert eine enge Zusammenarbeit zwischen [DevOps](/kubernetes/), MLOps und Plattformengineering. Die richtige Zuordnung von Verantwortlichkeite
Die Agent Baseline ist ein Sicherheitsrahmen für die Einführung von KI-Agenten in Unternehmen, der sechs wesentliche Sicherheitsziele definiert. Dieser Rahmen soll sicherstellen, dass Agenten in ihrer
Das ModelPack-Projekt zielt darauf ab, die Interoperabilität von KI-Modellen durch die Entwicklung eines offenen Standards zu verbessern. In Zusammenarbeit mit [Docker](/kubernetes/) werden OCI-Artifa
Grüne Statusmeldungen bestätigen erfolgreiche Sicherungen. Backup-Jobs laufen automatisch im Hintergrund und vermitteln ein Gefühl von Sicherheit.
Mehr Informationen im [Originalartikel](https://www.docker.com/blog/agentic-ai-needs-guardrails-not-guesswork/).
Das CNCF-White Paper zu Datenspeicherung in [Cloud Native](https://cloud-native/) AI behandelt die Herausforderungen und Lösungen für die Speicherung von Daten in KI- und ML-Workloads. Es identifizier
Die Einführung von Künstlicher Intelligenz im Mittelstand hat eine neue Sicherheitsfront eröffnet. Wenn wir LLMs trainieren oder RAG-Systeme (Retrieval Augmented Generation) aufbauen, bewegen wir massive Mengen sensibler Daten durch unseren Kubernetes-Cluster – oft direkt auf leistungsstarke GPU-Nodes.
Spätestens seit dem Durchbruch von ChatGPT ist klar: KI kann mehr als nur Zahlen analysieren. Sie kann Berichte schreiben, Wartungsanleitungen zusammenfassen und Anomalien in menschlicher Sprache erklären. Analyse-Software für Sensordaten nutzt LLMs, um Technikern in der Werkhalle präzise Handlungsanweisungen zu geben: „Vibration an Lager 4 deutet auf Fettmangel hin - bitte bis Schichtende nachschmieren."
Die europäische Debatte um „souveräne KI" wird oft auf die Ebene von Regulierung, Datenschutz und gesellschaftlicher Akzeptanz reduziert. Was dabei gerne übersehen wird: Souveränität in Künstlicher Intelligenz entscheidet sich nicht nur an Algorithmen oder Modellen, sondern ganz wesentlich an der Lieferkette der zugrundeliegenden Hardware. Ohne Chips, ohne GPUs, ohne die notwendige Infrastruktur ist jede Vision einer europäischen KI-Souveränität nicht mehr als eine akademische Übung. In diesem Beitrag möchte ich die realen Engpässe aufzeigen, die Europa auf diesem Weg blockieren, und gleichzeitig die Handlungsräume benennen, die bleiben. Es wird kein romantisches Plädoyer für Autarkie, sondern eine nüchterne Analyse von Abhängigkeiten, Marktmechanismen und industriepolitischen Optionen.
Künstliche Intelligenz (KI) ist der neue Standard, aber die Nutzung von Cloud-APIs wie OpenAI (ChatGPT) oder Anthropic hat einen massiven Haken: Datenschutz und "Data Gravity". Sensible Unternehmensdaten, Quellcode oder Kundeninformationen an US-Server zu senden, ist oft ein DSGVO-Albtraum und ein strategisches Risiko. Ollama ändert die Spielregeln. Es ist eine extrem leichtgewichtige Engine, um potente Open-Source-Modelle (wie Meta's Llama 3, Mistral oder Gemma) direkt im eigenen Cluster auszuführen. Wer Ollama nutzt, erhält die volle Power von Generativer KI – aber ohne dass auch nur ein einziges Byte das eigene Netzwerk verlässt.
Künstliche Intelligenz ist im E-Commerce kein Hype mehr, sondern ein Werkzeug zur Skalierung. Ob es um die Generierung von Produktbeschreibungen aus technischen Merkmalen, das Umschreiben von SEO-Texten oder automatisierte Antworten im Kundensupport geht - Large Language Models (LLMs) sparen hunderte Arbeitsstunden.
Wer heute eine NVIDIA H100 oder A100 in seinen Cluster integriert, stellt schnell fest: Die klassische 1-zu-1-Zuweisung (ein Pod reserviert eine ganze GPU) ist im produktiven Alltag oft eine massive Kapitalverschwendung. Während das Training von LLMs die Hardware voll ausreizt, langweilen sich GPUs beim Inferenz-Betrieb oder in Entwicklungs-Umgebungen oft bei 10 % Auslastung.
Der Hype um generative künstliche Intelligenz (KI) und Large Language Models (LLMs) hat sich im Mittelstand zu einer handfesten operativen Realität entwickelt. Ob automatisierte Ticket-Zusammenfassungen im Support, intelligente E-Mail-Entwürfe im Vertrieb oder das strukturierte Durchsuchen von Tausenden internen Projektdokumenten: Die Effizienzgewinne sind unbestreitbar.
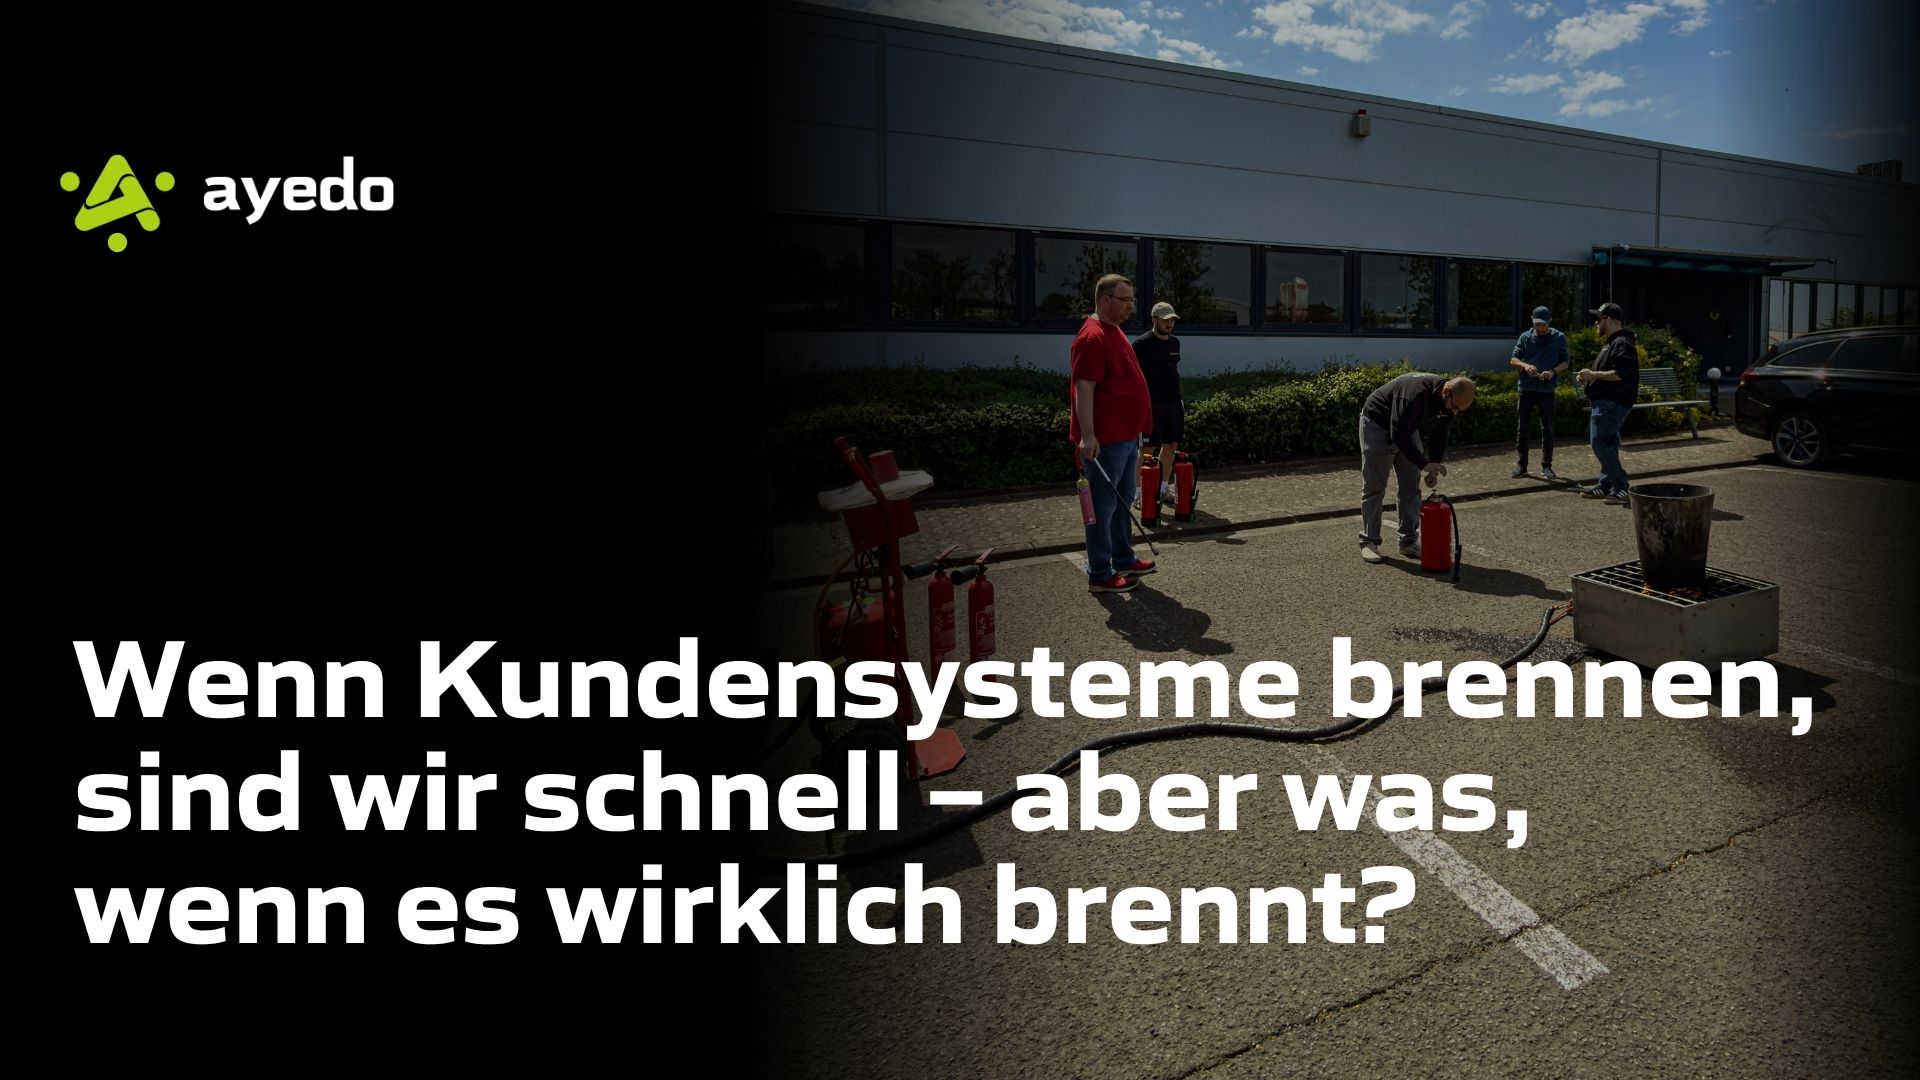
Wenn Kundensysteme brennen, sind wir wie die Feuerwehr – schnell, strukturiert, lösungsorientiert.\nAber was passiert, wenn es im eigenen Unternehmen wirklich brennt?
Kubernetes v1.36 führt die Möglichkeit ein, Ressourcenanforderungen und -limits von Pods in angehaltenen Jobs anzupassen, was zuvor nur in der Alpha-Phase verfügbar war. Diese Funktion ermöglicht es C
Polycrate CLI 0.33.0: spec list und release list mit erweiterten Filtern und Ausgabeformaten, Volume Discovery für Kubernetes PersistentVolumes und kompakter Ansible-Output.
Polycrate CLI 0.32.0 erweitert Spec-Driven Development: Typen nach Conventional Commits, Abhängigkeiten, Labels, Quick-Capture und Release-Guards für robustere Agent-Workflows.

In der Softwareentwicklung ist Git die „Source of Truth". Wenn etwas nicht funktioniert, schaut man in die Commit-Historie. In der Welt der Künstlichen Intelligenz reicht das nicht aus. Ein Modell besteht nicht nur aus Code, sondern aus der Kombination von **Code, Daten und Hyperparametern**.
In einem Pilotprojekt verzeiht man einer KI vieles. Wenn die Vorhersage einer Anomalie mal zwei Sekunden dauert, ist das kein Weltuntergang. Doch in der industriellen Fertigung - etwa bei der Überwachung von Hochgeschwindigkeits-Pressen oder Roboterarmen - ist Zeit kein relativer Begriff, sondern ein harter Vertragsparameter (SLA).
In der industriellen KI, wie bei der Predictive Maintenance von Sensordaten-Analyse-Software, sind Datenströme das Lebenselixier. Tausende Sensoren liefern sekündlich Messwerte, die gefiltert, aggregiert und an Inferenz-Modelle weitergereicht werden müssen. Als Herzstück dieser Pipeline hat sich **Apache Kafka** etabliert.
In vielen Machine-Learning-Teams herrscht ein ungeschriebenes Gesetz: Wer zuerst kommt, mahlt zuerst. Wer am Morgen den ersten Trainings-Job startet, belegt die GPU - oft für den ganzen Tag. Die restlichen Data Scientists warten, schwenken auf langsame CPU-Instanzen um oder buchen teure Schatten-IT in der Public Cloud.
Polycrate CLI 0.31.0 führt Spec-Driven Development ein — ein vollständiges Lifecycle-Management-System für Specs und Releases, das die Zusammenarbeit zwischen Entwicklern und Coding Agents strukturiert.
In der traditionellen Softwareentwicklung hat sich CI/CD (Continuous Integration / Continuous Deployment) längst als Standard etabliert. Doch in der Welt der Künstlichen Intelligenz reicht das nicht aus. KI-Modelle sind keine statischen Artefakte; sie basieren auf Code, Daten und Parametern, die sich ständig ändern. Ohne eine automatisierte Pipeline - bekannt als **MLOps** - landen viele Modelle als „Experimente" in der Schublade, anstatt echten Geschäftswert zu liefern.
Ein Large Language Model (LLM) ohne Zugriff auf aktuelle Unternehmensdaten ist wie ein brillanter Professor ohne Bibliothek: Er hat das Wissen der Welt, kennt aber nicht Ihre spezifischen Projekte, Dokumente oder Kundenhistorien. Um KI-Agenten wirklich nützlich zu machen, nutzen wir **Retrieval Augmented Generation (RAG)**. Das Herzstück dieser Architektur ist die **Vektor-Datenbank**.
Wer Large Language Models (LLMs) oder komplexe Deep-Learning-Pipelines in Produktion bringt, merkt schnell: Ein Standard-Kubernetes-Cluster stößt bei diesen "Heavy Workloads" sofort an seine Grenzen. Wenn Terabytes an Gewichten in den VRAM geladen werden müssen und Milliarden von Checkpoints über das Netzwerk fließen, entscheiden Nuancen in der Infrastruktur-Konfiguration über Erfolg oder ein technisches Desaster.
In der modernen IT-Infrastruktur ist die GPU zur neuen CPU geworden. Ob Large Language Models (LLMs), Computer Vision oder komplexe Datenanalysen - der Hunger nach Rechenleistung auf Grafikkarten ist im Mittelstand massiv gestiegen. Doch während CPUs seit Jahrzehnten effizient virtualisiert und geteilt werden, stellen GPUs Plattform-Ingenieure oft vor ein Dilemma: Eine High-End-Grafikkarte (wie eine NVIDIA H100 oder A100) ist für einen einzelnen Microservice oft überdimensioniert, gleichzeitig aber zu teuer, um sie im Leerlauf zu lassen.
Der Hype um proprietäre SaaS-KI-Modelle weicht 2026 einer nüchternen Kosten-Nutzen-Rechnung. Während Unternehmen anfangs bereitwillig Token-Gebühren an Hyperscaler zahlten, zwingen steigende OpEx, strikte Latenzanforderungen und die Verschärfung regulatorischer Rahmenbedingungen wie der EU AI Act und NIS-2 zum Umdenken. Die Souveränität über die eigenen Daten und die Kontrolle über die Inferenz-Kosten führen zu einer massiven Rückverlagerung von KI-Workloads in die eigene Cloud-Native Infrastruktur.
Polycrate API 0.12.0 bringt den App-Katalog als First-Class ManagedObject, AI-gestuetzte Maintenance-Erkennung via OpenAI, das Provider Model und Workspace Pop Required.
In einer klassischen IT-Infrastruktur gab es eine klare Kausalkette: Ein Administrator änderte eine Zeile Code, und das System reagierte. In der Welt der **Agentic AI** trifft die KI autonome Entscheidungen (z. B. das Terminieren von Instanzen oder das Umrouten von Traffic), basierend auf Milliarden von Parametern. Ohne eine Strategie für **Explainability**(Erklärbarkeit) wird die Infrastruktur unberechenbar.
Der Hype um Künstliche Intelligenz hat eine neue Ära der IT-Ausgaben eingeläutet. Wer heute LLMs (Large Language Models) trainiert oder produktiv betreibt, merkt schnell: Die Kosten für Grafikprozessoren (GPUs) folgen ganz anderen Gesetzen als klassische CPU-Instanzen. Eine einzelne H100-Instanz in der Cloud kann pro Monat so viel kosten wie ein Kleinwagen.
In den letzten zehn Jahren war die Marschrichtung klar: Alle Daten und Prozesse wandern in die zentrale Cloud. Doch wir stoßen an physikalische und ökonomische Grenzen. Wenn ein autonomes System in einer Fabrik auf ein Hindernis reagiert oder eine KI-gestützte Qualitätskontrolle am Fließband Millimeter-Entscheidungen trifft, ist der Weg in ein entferntes Rechenzentrum zu weit. Die Latenz wird zum Sicherheitsrisiko, und die Kosten für den Datentransport explodieren.
Polycrate CLI 0.29.16 bringt Echtzeit Pod-Status-Tracking für K8sApps, eine MCP Knowledge Base für LLM-gestützte Block-Entwicklung und Host UID/GID Environment Variables.
Wenn ein KI-Modell die Trainingsphase verlässt, beginnt die eigentliche Herausforderung: Der produktive Inferenz-Betrieb. Ein Large Language Model (LLM) in einem Standard-Container zu „serven", ist ineffizient. Die Latenzen sind zu hoch und die GPU-Auslastung ist oft miserabel, da klassische Web-Server nicht für die sequenzielle Natur der Token-Generierung gebaut sind.
In einer Retrieval Augmented Generation (RAG) Architektur ist die Vektor-Datenbank (Vector DB) das Herzstück. Sie liefert dem Large Language Model (LLM) den Kontext aus Ihren Unternehmensdaten. Doch während herkömmliche Datenbanken vor allem Disk-I/O-optimiert sind, stellen Vektor-Datenbanken wie **Qdrant, Weaviate oder Milvus** völlig neue Anforderungen an Ihre Kubernetes-Infrastruktur.
Wer klassische Microservices betreibt, weiß: Metriken, Logs und Traces sind die Lebensversicherung. Doch bei KI-Workloads stoßen herkömmliche Monitoring-Ansätze an ihre Grenzen. Eine CPU-Auslastung von 10 % sagt uns nichts darüber aus, ob die Antwortqualität eines Sprachmodells gerade einbricht oder ob die Vektor-Suche ineffizient arbeitet.
Die Begeisterung für Large Language Models (LLMs) und generative KI hat eine fundamentale Frage in die IT-Abteilungen zurückgebracht: Wie skalieren wir Machine Learning (ML) Workloads, ohne eine parallele Schatten-IT aufzubauen?
Fast jedes moderne Unternehmen arbeitet heute an einer KI-Strategie. Ob Large Language Models (LLMs), Bilderkennung in der Qualitätskontrolle oder prädiktive Analysen – der Hunger nach Rechenleistung ist enorm. Doch während die Algorithmen immer präziser werden, stehen IT-Abteilungen vor einem neuen, physischen Problem: GPUs (Grafikprozessoren) sind teuer, schwer verfügbar und ihre Verwaltung unterscheidet sich grundlegend von klassischer IT-Infrastruktur.
Die rasante Entwicklung von Künstlicher Intelligenz, insbesondere von Large Language Models (LLMs) wie Google Gemini oder OpenAI's ChatGPT, hat das Potenzial, unsere Welt zu revolutionieren. Leider bleiben diese mächtigen Werkzeuge auch der Cyberkriminalität nicht verborgen. Bedrohungsakteure sind längst von der bloßen Produktivitätssteigerung (z. B. dem Verfassen besserer Phishing-E-Mails) zur aktiven **Weaponisierung von KI in Malware und Angriffsmethoden** übergegangen.
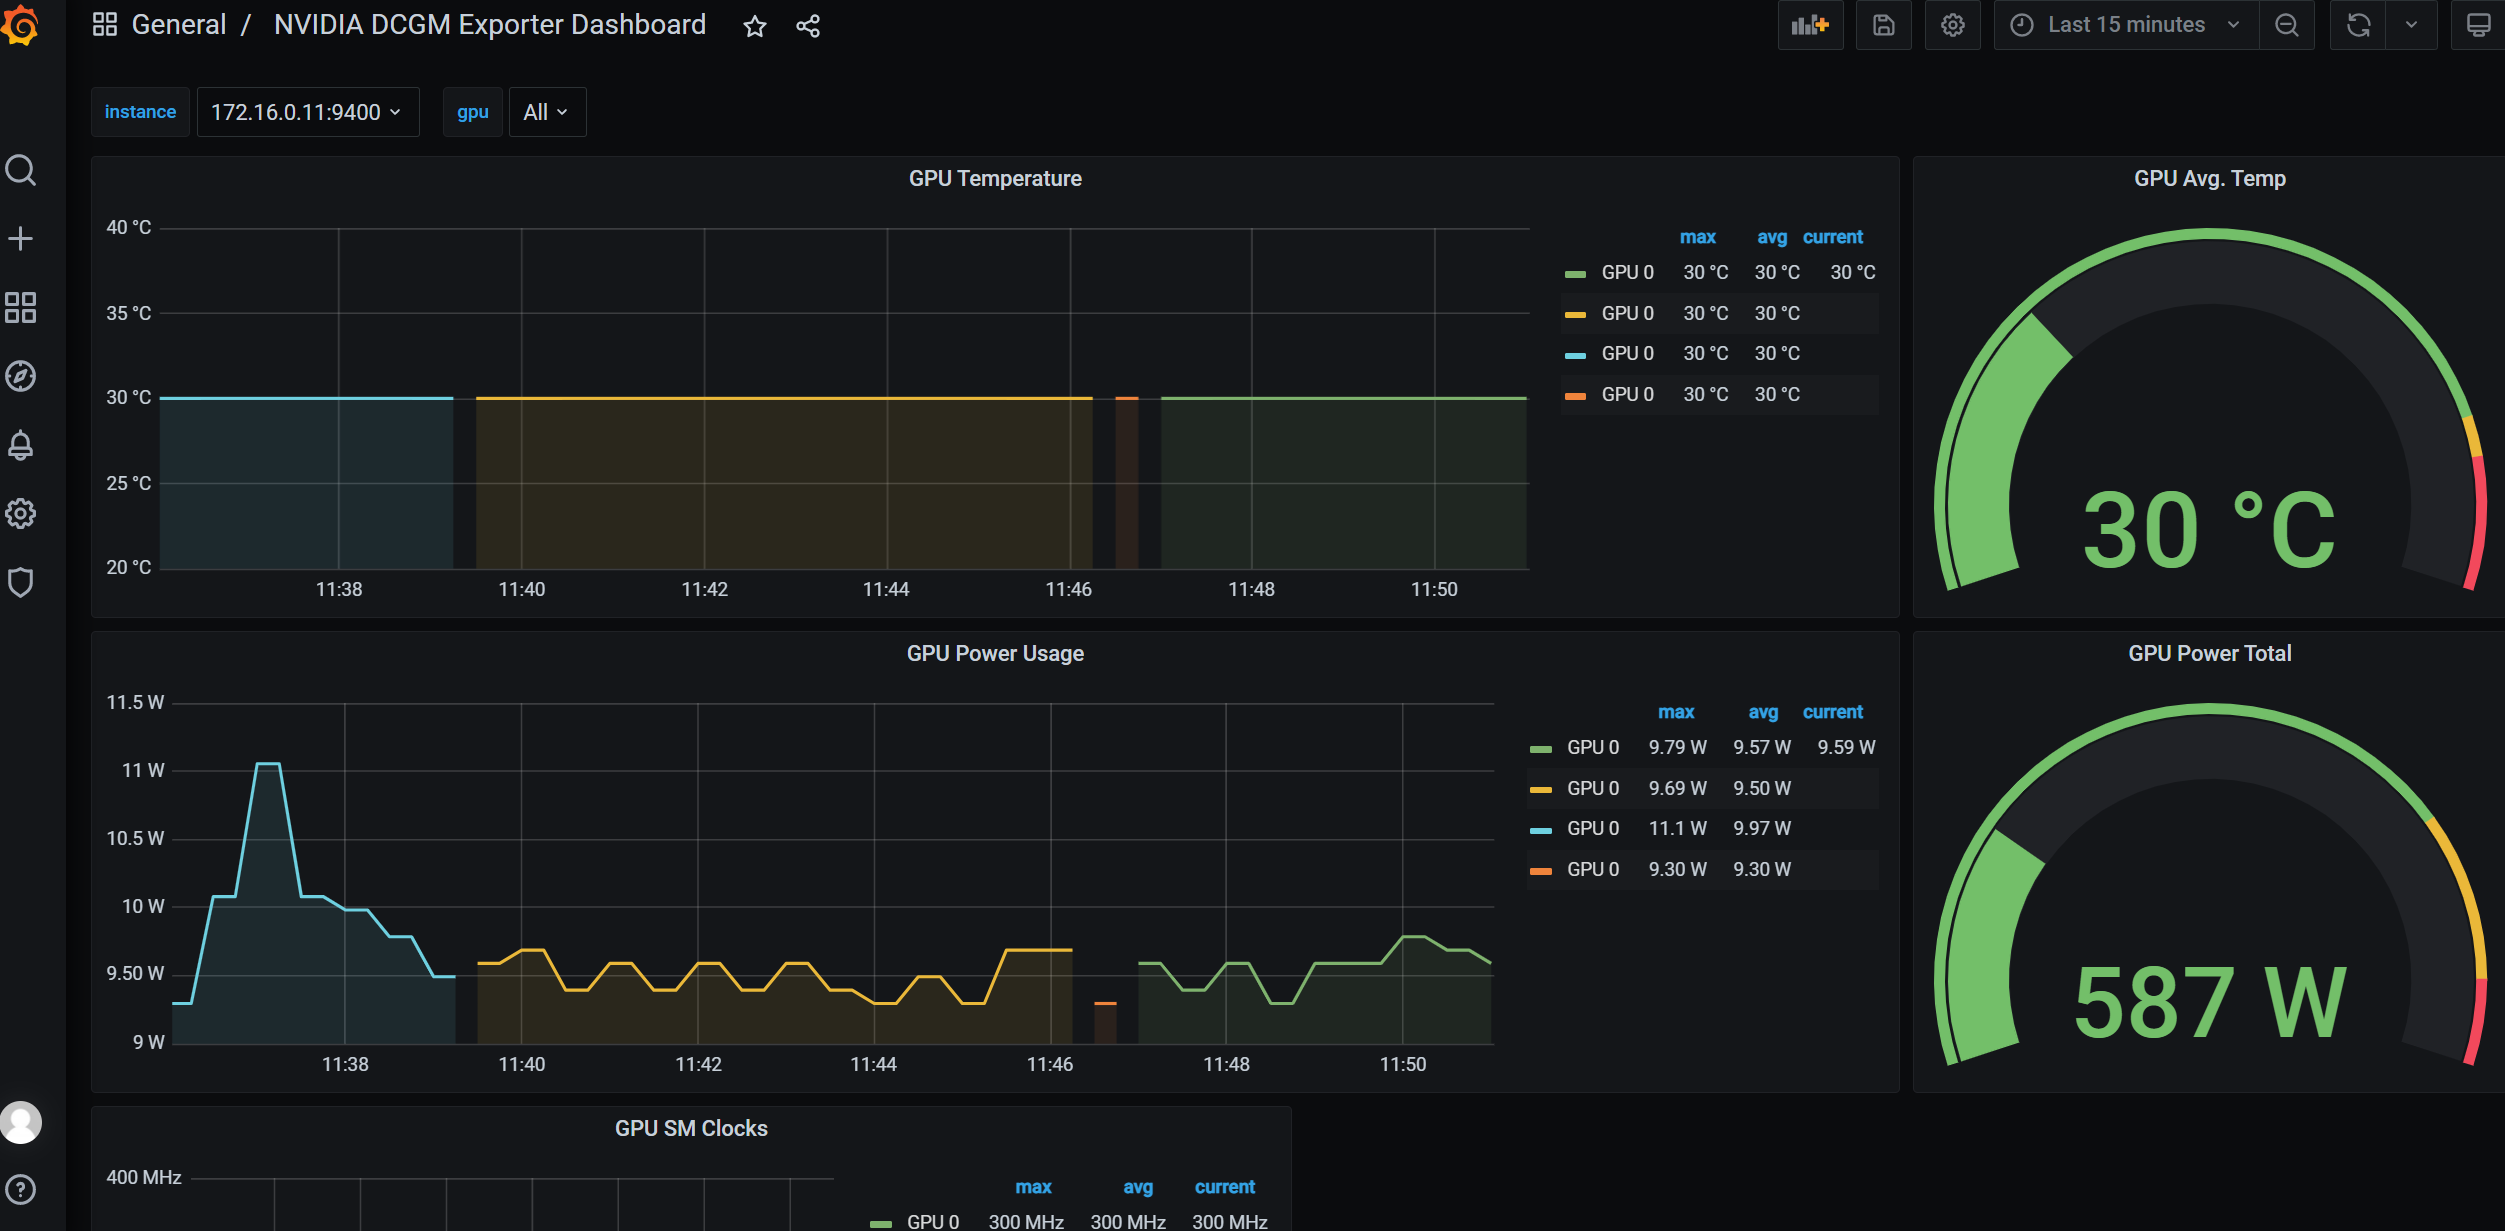
Wie du GPU‑Ressourcen sicher, effizient und cloud‑native für Entwicklung, Inferenz und Training bereitstellst – inklusive H100‑MIG und Time‑Slicing, YAML‑Beispielen und Betriebsrichtlinien.
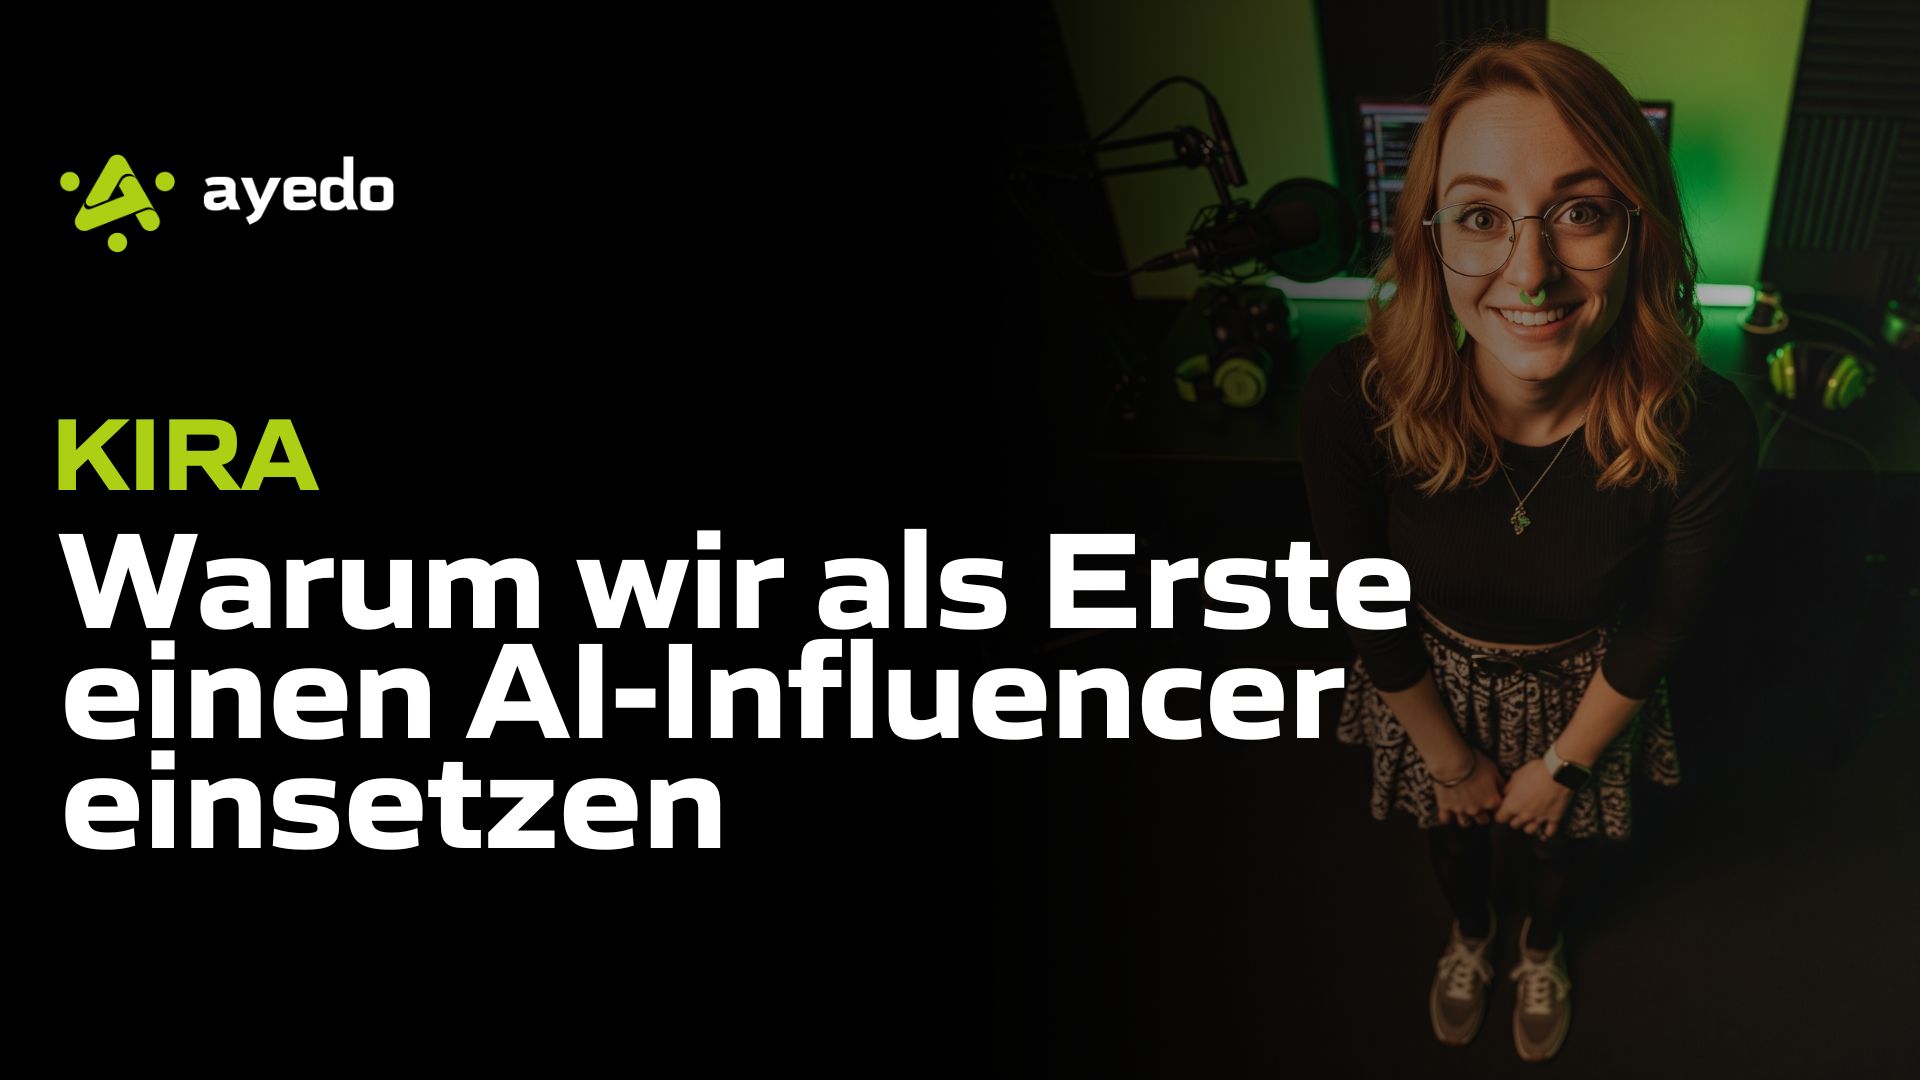
Ein AI-Influencer ist kein Mensch, der spontan entscheidet, ob heute ein Video oder ein Post dran ist. Ein AI-Influencer ist eine digitale Persona, komplett konstruiert, immer verfügbar, niemals urlaubsreif, und in der Lage, in Sekunden hochwertigen Content zu produzieren. Genau das ist Kira. Sie wird für uns sprechen – über Cloud-Native-Technologien, AI- und Hosting-News, in Videos, Podcasts und auf LinkedIn.