Blog
Cloud-Native Insights & Expertise

Entdecken Sie unsere neuesten Artikel über Cloud-Native Technologien, Kubernetes, DevOps und moderne Software-Entwicklung. Von praktischen Tutorials bis hin zu tiefgreifenden Analysen.

Neueste Blog-Posts

Bleiben Sie auf dem Laufenden mit unseren aktuellsten Artikeln über Cloud-Native Technologien, Kubernetes und DevOps.

1242 Beiträge

Schluss mit dem Leerlauf: Rightsizing-Tools für effiziente Kubernetes-Cluster

Schluss mit dem Leerlauf: Rightsizing-Tools für effiziente Kubernetes-Cluster

In der klassischen Server-Welt galt: „Lieber zu viel RAM als zu wenig." In Kubernetes führt diese Einstellung direkt zu einer aufgeblähten Cloud-Rechnung. Da Kubernetes Pods basierend auf ihren **Resource Requests** (Reservierungen) plant, bezahlen Sie für den Platz, den Sie reservieren – völlig egal, ob Ihre Applikation ihn tatsächlich nutzt.
ArgoCD: Die Referenz-Architektur für deklaratives GitOps auf Kubernetes

ArgoCD: Die Referenz-Architektur für deklaratives GitOps auf Kubernetes

ArgoCD hat sich als der Industriestandard für Continuous Delivery in Kubernetes etabliert. Durch die Implementierung des GitOps-Paradigmas transformiert es die Infrastrukturverwaltung von imperativen Pipelines hin zu einer deklarativen Zustandsverwaltung. Dies ermöglicht automatisierte Synchronisierung („Self-Healing"), lückenlose Auditierbarkeit und eine strikte Trennung von CI (Continuous Integration) und CD (Continuous Delivery).

Policy-as-Code: Compliance automatisiert durchsetzen

Policy-as-Code: Compliance automatisiert durchsetzen

Im Jahr 2026 ist Compliance kein "Papiertiger" mehr. Mit Regularien wie dem Cyber Resilience Act oder Zertifizierungen nach ISO 27001 und TISAX stehen IT-Verantwortliche vor einer gewaltigen Aufgabe: Sie müssen beweisen, dass Sicherheitsrichtlinien nicht nur existieren, sondern lückenlos und permanent in ihren Kubernetes-Clustern erzwungen werden.

Alte Eisen, neue Hülle: Wie man Legacy-Monolithen mit Kubernetes-Sidecars modernisiert

Alte Eisen, neue Hülle: Wie man Legacy-Monolithen mit Kubernetes-Sidecars modernisiert

„Das können wir nicht in die Cloud schieben, das ist ein Monolith." Diesen Satz hören wir oft. Doch Modernisierung bedeutet 2026 nicht mehr zwangsläufig, eine gewachsene Java- oder .NET-Applikation in kleinste Microservices zu zerlegen (Refactoring). Oft ist der schnellere und wirtschaftlichere Weg das **Re-Platforming** unter Nutzung des **Sidecar-Patterns**.

K8s am Point of Sale: Warum Produktion und Handel auf Edge-Cluster setzen

K8s am Point of Sale: Warum Produktion und Handel auf Edge-Cluster setzen

Lange Zeit galt Kubernetes als das Betriebssystem für das „große" Rechenzentrum. Doch 2026 findet die spannendste Entwicklung am Rand des Netzwerks statt – am **Edge**. Ob es die Bildverarbeitung in der Qualitätskontrolle einer Fabrik ist oder das Bestandsmanagement in hunderten Einzelhandelsfilialen: Zentrale Cloud-Lösungen stoßen hier an ihre Grenzen.

Supply Chain Security mit SBOM und Sigstore

Supply Chain Security mit SBOM und Sigstore

Stellen Sie sich vor, Sie kaufen ein Fertiggericht im Supermarkt, auf dem keine Zutatenliste steht. In der Softwareentwicklung war das jahrelang der Standard: Wir laden Container-Images aus dem Netz und vertrauen darauf, dass nur das drin ist, was draufsteht. Doch Vorfälle wie *Log4j* haben gezeigt: Eine einzige kompromittierte Bibliothek in der Lieferkette kann globale Infrastrukturen lahmlegen.

GreenOps auf Kubernetes: CO2-Emissionen pro Microservice messen und optimieren

GreenOps auf Kubernetes: CO2-Emissionen pro Microservice messen und optimieren

Nachhaltigkeit ist in der IT-Welt des Jahres 2026 kein bloßes Marketing-Schlagwort mehr. Mit der Ausweitung der EU-Berichtspflichten (CSRD) stehen IT-Entscheider vor einer neuen Herausforderung: Sie müssen den CO2-Fußabdruck ihrer digitalen Infrastruktur nicht nur schätzen, sondern präzise belegen.

Serving am Limit: LLM-Inferenz mit vLLM und Triton auf Kubernetes

Serving am Limit: LLM-Inferenz mit vLLM und Triton auf Kubernetes

Wenn ein KI-Modell die Trainingsphase verlässt, beginnt die eigentliche Herausforderung: Der produktive Inferenz-Betrieb. Ein Large Language Model (LLM) in einem Standard-Container zu „serven", ist ineffizient. Die Latenzen sind zu hoch und die GPU-Auslastung ist oft miserabel, da klassische Web-Server nicht für die sequenzielle Natur der Token-Generierung gebaut sind.

Vector Databases on K8s: Performance-Tuning für RAG-Applikationen

Vector Databases on K8s: Performance-Tuning für RAG-Applikationen

In einer Retrieval Augmented Generation (RAG) Architektur ist die Vektor-Datenbank (Vector DB) das Herzstück. Sie liefert dem Large Language Model (LLM) den Kontext aus Ihren Unternehmensdaten. Doch während herkömmliche Datenbanken vor allem Disk-I/O-optimiert sind, stellen Vektor-Datenbanken wie **Qdrant, Weaviate oder Milvus** völlig neue Anforderungen an Ihre Kubernetes-Infrastruktur.

KI-Observability: Monitoring von LLMs und RAG-Pipelines in Kubernetes

KI-Observability: Monitoring von LLMs und RAG-Pipelines in Kubernetes

Wer klassische Microservices betreibt, weiß: Metriken, Logs und Traces sind die Lebensversicherung. Doch bei KI-Workloads stoßen herkömmliche Monitoring-Ansätze an ihre Grenzen. Eine CPU-Auslastung von 10 % sagt uns nichts darüber aus, ob die Antwortqualität eines Sprachmodells gerade einbricht oder ob die Vektor-Suche ineffizient arbeitet.

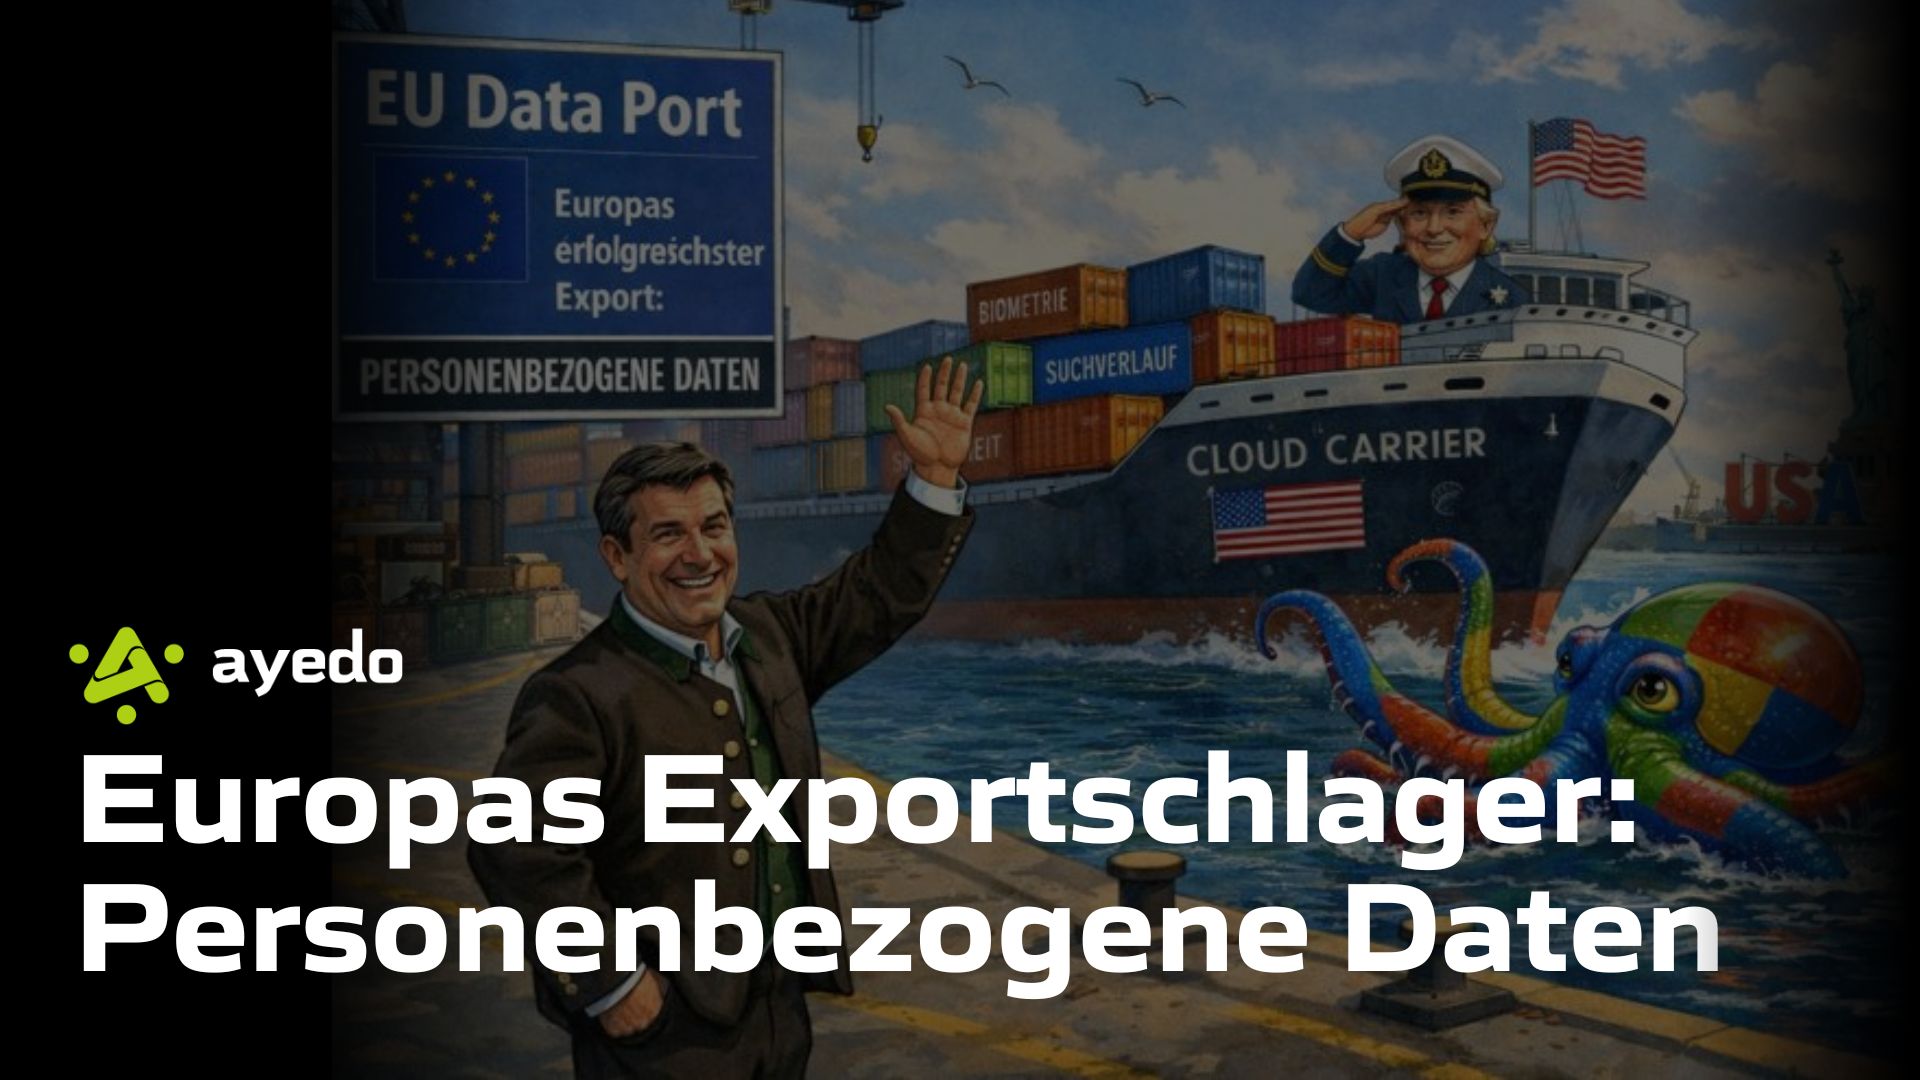
Europas Exportschlager: Personenbezogene Daten

Europas Exportschlager: Personenbezogene Daten

Europa versteht sich gern als globaler Hüter von Datenschutz und Grundrechten. DSGVO, NIS2, AI Act – der regulatorische Anspruch ist hoch, die Rhetorik selbstbewusst. In der operativen Realität entsteht jedoch ein anderes Bild: Personenbezogene Daten europäischer Bürgerinnen, Bürger und Unternehmen werden systematisch in Infrastrukturen ausgelagert, die außerhalb europäischer Rechts- und Kontrollräume liegen. Nicht illegal, aber politisch kurzsichtig. Nicht aus Zwang, sondern aus Bequemlichkeit.