Entdecken Sie unsere neuesten Artikel über Cloud-Native Technologien, Kubernetes, DevOps und moderne Software-Entwicklung. Von praktischen Tutorials bis hin zu tiefgreifenden Analysen.
In der Industrie 4.0 ist die Cloud ein mächtiger Verbündeter für Datenanalyse und KI. Doch für den täglichen Betrieb in der Werkshalle gilt ein eisernes Gesetz: **Die Produktion darf niemals stillstehen** - erst recht nicht, weil eine Internetverbindung abbricht.
Kubernetes ist eine Open-Source-Plattform zur Orchestrierung containerisierter Anwendungen. Sie übernimmt die Automatisierung von Deployment, Skalierung und Betrieb und bildet damit das Fundament moderner, cloud-nativer Infrastrukturen. Im Kern basiert Kubernetes auf einem deklarativen Modell: Der gewünschte Zustand wird beschrieben – und Controller sorgen kontinuierlich dafür, dass dieser Zustand erreicht und gehalten wird.
In der klassischen Datenverarbeitung dominierten lange Zeit "Batch-Prozesse": Daten wurden über den Tag gesammelt und nachts in großen Paketen verarbeitet. Für moderne Industrie-Anwendungen ist das zu langsam. Wenn eine Turbine im Werk Anomalien aufweist oder ein eCommerce-System auf Lagerbestandsänderungen reagieren muss, zählt jede Sekunde.
In der Welt des Data Engineerings gibt es ein Sprichwort: „Daten zu speichern ist einfach, sie schnell abzufragen ist die Kunst." Wenn wir über Petabytes an industriellen Sensordaten oder Milliarden von eCommerce-Events sprechen, kapitulieren klassische relationale Datenbanken wie PostgreSQL oder MySQL.
Wer moderne Data-Engineering-Pipelines baut, kommt an S3 (Simple Storage Service) nicht vorbei. Er ist der Industriestandard für den Zugriff auf unstrukturierte Daten, Modell-Checkpoints und Data Lakes. Doch was tun, wenn die Daten aus Compliance-Gründen On-Premise bleiben müssen oder die Egress-Kosten der Hyperscaler das Budget sprengen?
In der Softwareentwicklung ist das Problem längst gelöst: Code wird in Git versioniert, in Containern isoliert und über CI/CD-Pipelines identisch auf verschiedenen Umgebungen ausgespielt. Im Data Engineering und bei KI-Workloads sieht die Realität oft anders aus.
In der Theorie ist Künstliche Intelligenz ein Heilsbringer für die Industrie. In der Praxis scheitert die Umsetzung oft an einer profanen Hürde: Hardware-Verfügbarkeit. Wer heute High-End-GPUs (wie die NVIDIA H100 oder A100) für das Training von Modellen oder komplexe Simulationen benötigt, steht vor langen Lieferzeiten oder astronomischen Fixkosten im eigenen Rechenzentrum.
In der Welt des Data Engineerings ist Apache Airflow der unangefochtene Champion für die Orchestrierung von Workflows. Doch mit dem Erfolg kommen die Skalierungsschmerzen: Lokale Executor stoßen an CPU-Grenzen, Celery-Worker-Cluster sind mühsam zu warten und Ressourcen liegen brach, wenn gerade keine DAGs laufen.
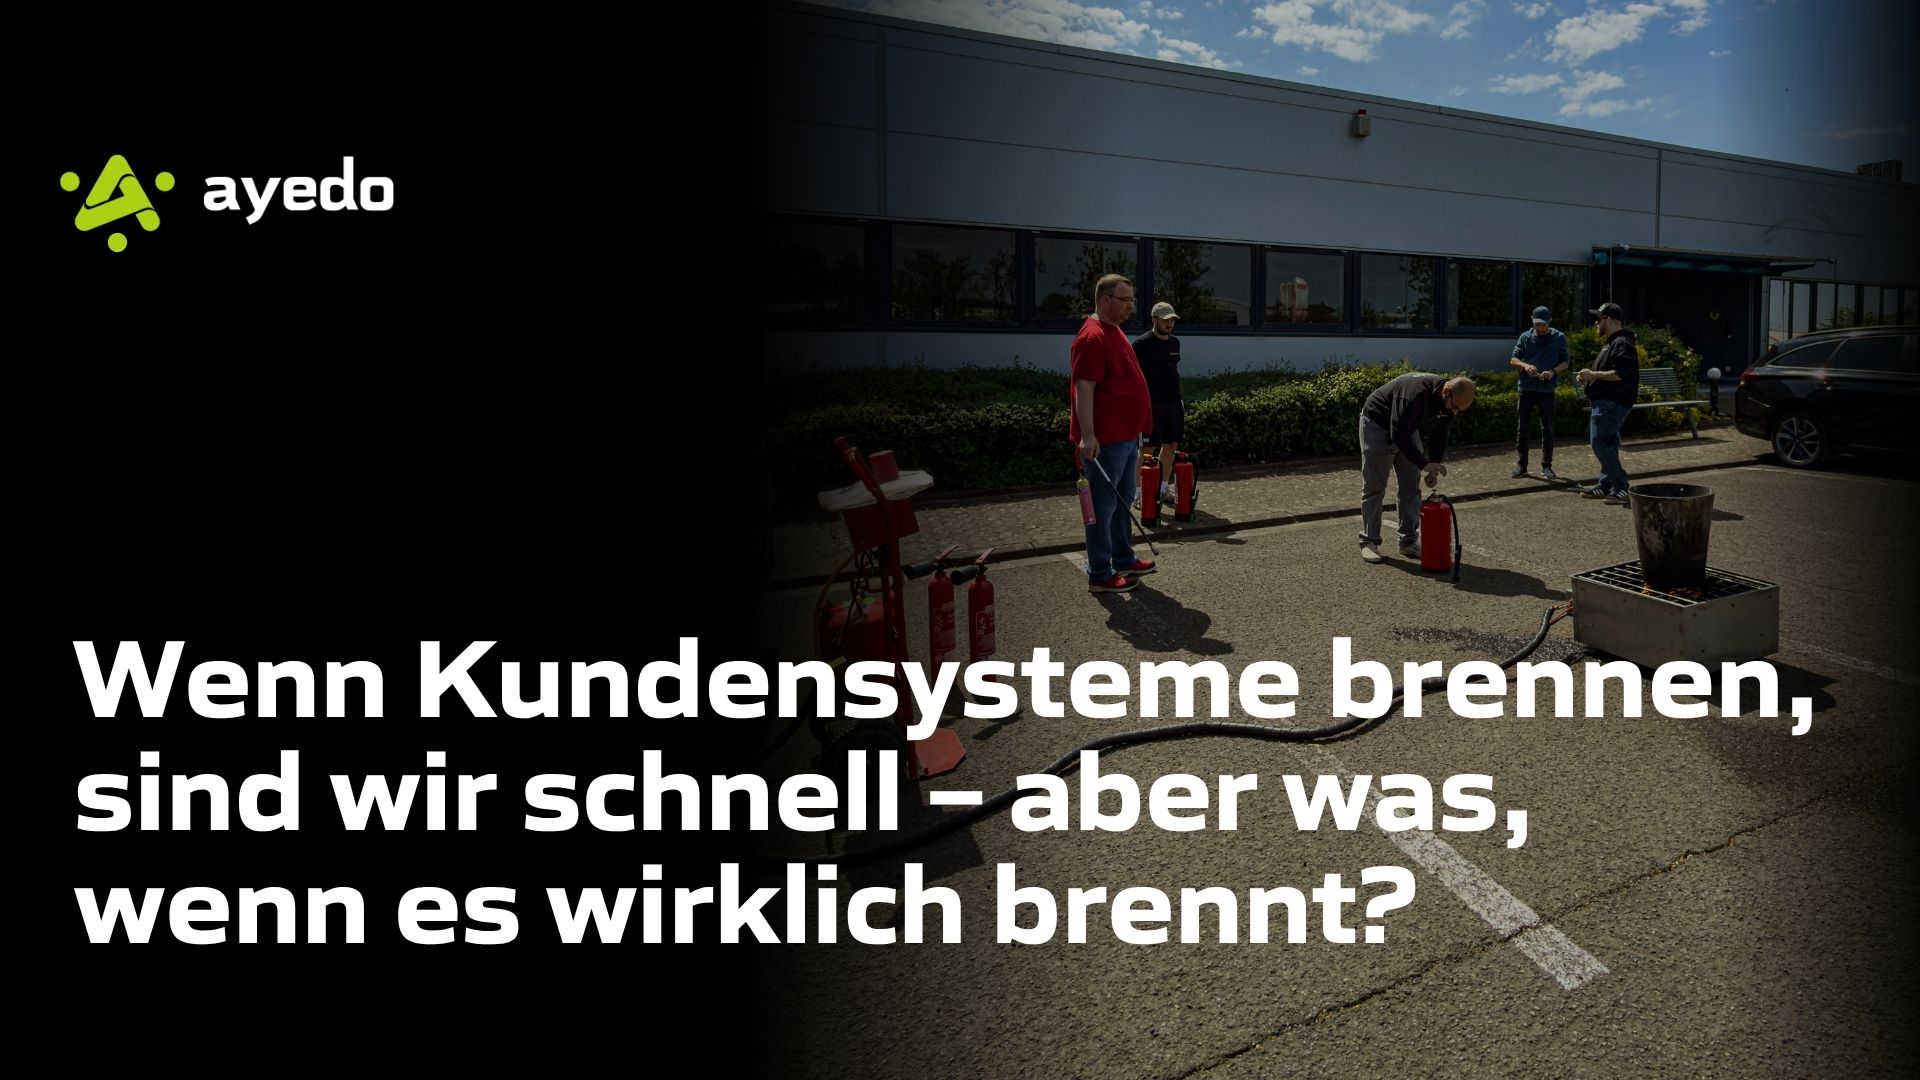
Wenn Kundensysteme brennen, sind wir wie die Feuerwehr – schnell, strukturiert, lösungsorientiert.\nAber was passiert, wenn es im eigenen Unternehmen wirklich brennt?
Polycrate API 0.15.0 ist ein grosses Bundled-Release mit 126 Changes seit 0.14.17: User/Contact-Migration mit Keycloak, Artifacts-zu-Blocks-Refactoring abgeschlossen, externe DNS via Lexicon, K8sVolume und DNSZone als Productized Models, Managed Object Dashboard flaechendeckend, generisches RBAC und Labels via OpenAPI.
In modernen Enterprise-IT-Umgebungen stoßen klassische, über Jahre gewachsene Ansible-Strukturen zunehmend an ihre Belastungsgrenzen. Was oft als effiziente Lösung für Ad-hoc-Automatisierung begann, manifestiert sich heute als unübersichtlicher "Playbook-Wildwuchs" und die berüchtigte "Python-Dependency-Hölle". Die manuelle Pflege von Virtual Environments auf individuellen Administrator-Workstations ("Snowflake-Workstations") führt zu Inkonsistenzen, erschwert das Onboarding und stellt ein erhebliches Compliance-Risiko dar. Polycrate fungiert hier als strategischer Enabler: Es transformiert die Automatisierung von einer skriptbasierten Tätigkeit in eine skalierbare Plattformarchitektur. Dies sichert nicht nur die operative Exzellenz, sondern stärkt die digitale Souveränität durch providerunabhängige, reproduzierbare Prozesse, die das Deployment-Tooling von der zugrunde liegenden Cloud-Infrastruktur entkoppeln.
Polycrate CLI 0.37.0: Breaking Change — SSH Agent Mount ist per Default deaktiviert und muss bei Bedarf explizit aktiviert werden. Verbesserte Kompatibilität mit OrbStack, Colima und Lima auf macOS.
Polycrate CLI 0.36.0: SSH Agent Mount per Flag/Config deaktivierbar (OrbStack-Workaround), Exit Code Normalisierung bei Docker-Infrastrukturfehlern und verbessertes Error-Logging.
In der Anfangsphase eines SaaS-Produktes oder einer eCommerce-Lösung ist Geschwindigkeit alles. Um schnell live zu gehen, ist der Weg über virtuelle Maschinen (VMs) und ein paar gut gemeinte Bash-Skripte oft der Pfad des geringsten Widerstands. Es funktioniert – für den ersten Kunden, den zweiten und vielleicht noch den fünften.
Monitoring-Alerts sind in vielen IT-Organisationen zu einem Hintergrundrauschen verkommen. Wenn das Telefon nachts um drei klingelt, ist die erste Reaktion oft kein Adrenalin, sondern Genervtheit - gefolgt von der Erwartung, dass es sich ohnehin um einen Fehlalarm handelt. Diese **Alert Fatigue** ist kein menschliches Versagen, sondern das Resultat einer technisch veralteten Monitoring-Strategie. Ein System, das bei jedem transienten Netzwerk-Jitter eskaliert, ist kein Schutzmechanismus, sondern eine operative Belastung, die Kapazitäten bindet und das Fehlerrisiko bei echten Vorfällen massiv erhöht.
Polycrate CLI 0.35.0: Neuer S3Bucket Provisioning Controller für deklarative Bucket-Erstellung per Kubernetes CR, Operator Label-Migration auf einheitliches polycrate_* Format und Ansible Task-Fortschritt Analyse.
In der Fintech-Welt gibt es ein bekanntes Phänomen: Die Software ist großartig, das Team ist überzeugt, aber die Rechts- und Compliance-Abteilung der Großbank bremst den Abschluss über Monate aus. Der Grund ist fast immer derselbe: **Das Auslagerungsrisiko.** Wenn eine Bank ihre kritischen Prozesse in Ihre Cloud-Umgebung verlagert, verliert sie ein Stück Kontrolle - und genau hier setzen DORA und interne Richtlinien extrem hohe Hürden.
Wenn man eine DBaaS-Plattform skaliert, wird Storage schnell zum kritischsten Flaschenhals. Datenbanken stellen zwei gegensätzliche Anforderungen an die Speicherinfrastruktur: Einerseits verlangen sie extrem niedrige Latenzen für Schreib- und Lesevorgänge (I/O), andererseits erzeugen Backups und Transaktionslogs (WAL) gigantische Datenmengen, die kosteneffizient gelagert werden müssen.
Kubernetes klingt für viele zunächst wie ein reines Entwicklerthema – komplex, technisch und weit entfernt vom eigenen Arbeitsalltag. Doch genau das ist ein Trugschluss. Denn im Kern geht es bei Kubernetes um etwas sehr Grundlegendes: **Wie moderne Software zuverlässig betrieben wird**.
Frankreich macht ernst mit digitaler Souveränität. Die Regierung hat angekündigt, Windows aus der Verwaltung zu verdrängen und durch Linux zu ersetzen. Federführend ist die Digitalbehörde Dinum. Weitere zentrale Akteure wie die Cybersicherheitsbehörde und die staatliche Beschaffung sollen folgen. Ein konkreter Migrationsplan wird für Herbst 2026 erwartet.
In einer Multi-Region-Architektur ist "Konfigurations-Drift" der größte Feind der Ausfallsicherheit. Drift entsteht, wenn an Standort A ein dringender Hotfix eingespielt, eine Firewall-Regel angepasst oder ein Zertifikat erneuert wird - und man vergisst, diese Änderung an Standort B nachzuziehen. Im Ernstfall schwenkt der Traffic dann auf eine Region um, die nicht bereit ist, veraltet konfiguriert ist oder schlicht nicht funktioniert.
In der Welt der Kritischen Infrastrukturen (KRITIS) reicht es nicht aus, ein ausgeklügeltes Hochverfügbarkeitskonzept in der Schublade zu haben. Auditoren und Regulierer fordern heute den **technischen Beweis**, dass die theoretische Ausfallsicherheit in der Praxis auch wirklich greift. Ein Disaster-Recovery-Plan, der nur einmal im Jahr (oder gar nicht) getestet wird, gilt regulatorisch als hohes Risiko.
In der klassischen IT-Welt sind Wartungsfenster oft ein notwendiges Übel. Updates für das Betriebssystem, Kubernetes-Upgrades oder kritische Datenbank-Patches werden meist nachts oder am Wochenende durchgeführt, um die Beeinträchtigung für die Nutzer zu minimieren. In einer KRITIS-Umgebung, die 24/7-Verfügbarkeit erfordert, ist dieses Modell jedoch ein hohes Risiko: Wenn während der Wartung etwas schiefgeht, steht das System still, und die Redundanz ist während des Prozesses oft aufgehoben.
In der Welt der kritischen Infrastrukturen (KRITIS) wird der Erfolg eines Disaster-Recovery-Konzepts oft an harten Metriken wie der RTO (Recovery Time Objective) gemessen. Doch es gibt eine "weiche" Metrik, die in der Praxis über Akzeptanz oder Chaos entscheidet: Die **Nutzererfahrung im Moment des Umschaltens**.