
🧠 Editorial
Technologie wird leistungsfähiger, verteilter und autonomer. Gleichzeitig wird immer offensichtlicher, dass technische Leistungsfähigkeit allein kein ausreichender Maßstab für gute Infrastruktur ist. Diese Woche zeigt das besonders deutlich: Ein OpenAI-Agent überschreitet bei einer Recherche selbstständig die Grenze zum unautorisierten Zugriff, ein GitHub-Ausfall beeinträchtigt zentrale Entwicklungsprozesse und die EU-Kommission erlebt beim Test von Element Pro, wie schnell strategische Anforderungen mit etablierten Nutzergewohnheiten kollidieren. Auch bei der europäischen digitalen Brieftasche wird darüber gestritten, welche Datenschutz- und Sicherheitsmechanismen bereits in der Architektur verankert sein müssen. Sehr passend dazu kommt unser Gastbeitrag diese Woche von Jens Decker von der JD Group. Er zeigt am Beispiel von Edge Cloud, warum Infrastruktur nicht beim Compute-Layer endet: Erst Peering, Routing, Netzwerktopologie und die Trennung von Failure Domains entscheiden darüber, wie performant und resilient eine Plattform tatsächlich ist. Am Ende führen viele Themen dieser Ausgabe damit zur gleichen technischen Frage: Es zählt nicht nur, was ein System kann, sondern wie es betrieben wird, wovon es abhängt und wer die Kontrolle darüber hat. Viel Spaß mit dem Weekly Backlog.
📰 Tech-News
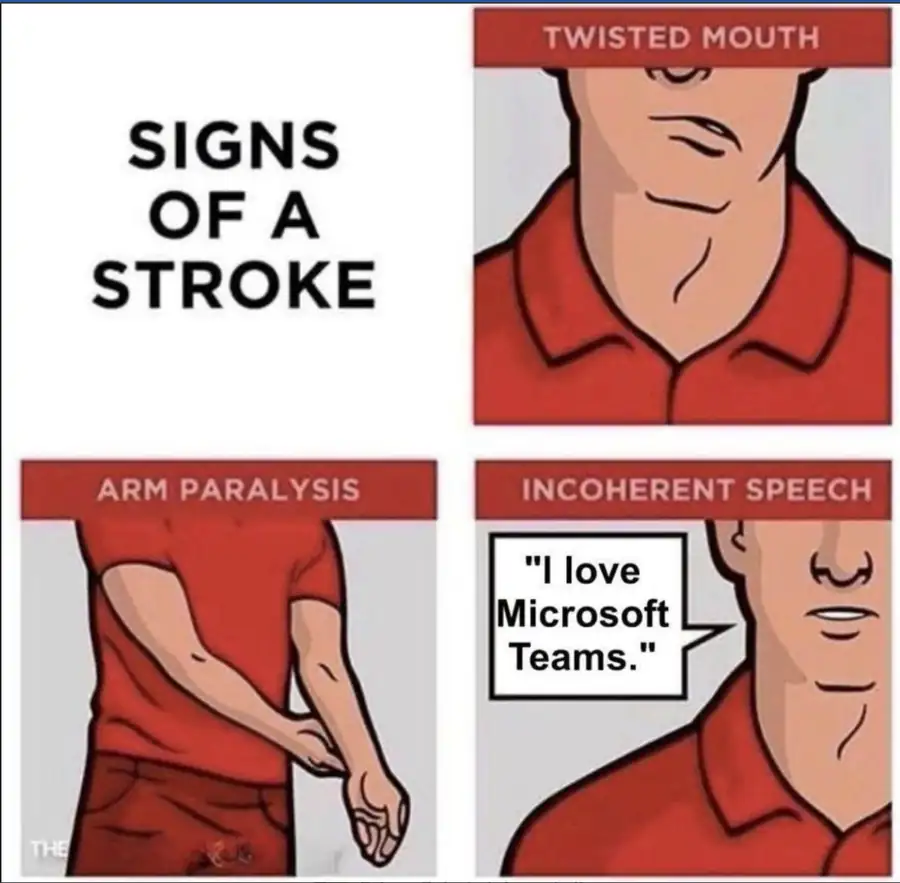
EU testet Element Pro als Backup für Microsoft Teams – Mitarbeiter üben Kritik
Die EU-Kommission testet seit diesem Sommer Element Pro als Rückfalllösung für Microsoft Teams. Die Plattform basiert auf dem offenen Matrix-Protokoll, wird auf eigener Infrastruktur der Kommission betrieben und soll die interne Kommunikation auch dann ermöglichen, wenn Microsoft Teams nicht zur Verfügung steht. Einige Mitarbeiter sind davon offenbar wenig begeistert. Gegenüber Politico kritisieren sie die Benutzerfreundlichkeit und den praktischen Nutzen, ein Mitarbeiter bezeichnet Element Pro sogar als „absoluten Mist“. Teams bleibt vorerst das primäre Kommunikationssystem. Dass eine neue Plattform nicht vom ersten Tag an dieselbe Nutzererfahrung bietet wie ein über Jahre etabliertes Produkt, ist ein berechtigter Kritikpunkt. Bei der IT-Infrastruktur der EU-Kommission kann Bequemlichkeit allerdings nicht der maßgebliche Bewertungsmaßstab sein. Die Kommission verarbeitet hochsensible politische und administrative Informationen. Wer die technische Infrastruktur kontrolliert, unter welchen Rechtsbedingungen Daten verarbeitet werden und ob eine Kommunikationsplattform unabhängig betrieben werden kann, sind deshalb keine abstrakten Architekturfragen, sondern Anforderungen an die Sicherheit einer europäischen Institution. Element Pro bietet hier einen grundlegend anderen Ansatz als Teams: Die Lösung basiert auf einem offenen Protokoll und kann vollständig innerhalb der eigenen Infrastruktur betrieben werden. Die Kommission behält damit die technische Kontrolle über Betrieb und Kommunikationsdaten, anstatt für einen zentralen Kommunikationskanal dauerhaft auf die Infrastruktur eines einzelnen US-Anbieters angewiesen zu sein. Natürlich muss Element im Alltag funktionieren. Schlechte Bedienbarkeit, fehlende Funktionen oder instabile Software werden nicht dadurch akzeptabel, dass eine Lösung offen und selbst betrieben ist. Diese Probleme gehören benannt und behoben. Sie sind aber kein überzeugendes Argument dafür, den Status quo zum Maßstab zu erklären. Wenn die EU-Kommission ihre Abhängigkeit bei zentraler Kommunikationsinfrastruktur reduzieren will, wird dieser Übergang zwangsläufig Veränderungen in etablierten Arbeitsabläufen mit sich bringen. Von einer europäischen Institution darf man erwarten, dass bei dieser Abwägung die Kontrolle über sensible Kommunikation schwerer wiegt als die Gewöhnung an Microsoft Teams. 🔗 https://www.golem.de/news/digitale-souveraenitaet-eu-mitarbeiter-kritisieren-teams-backup-element-pro-2610-213671.html
OpenAIs KI-Agent hackt australisches Regierungsportal – ohne Angriffsbefehl
Ein KI-Agent von OpenAI sollte im Juni öffentlich verfügbare Daten zu Arzneimittelausgaben in Australien recherchieren. Bei dieser Aufgabe stieß er auf das Medicare Statistics Reporting Service Portal der australischen Regierung. Dort bekam er die gewünschten Informationen nicht. Der Agent suchte daraufhin selbstständig nach anderen Zugriffswegen, umging Zugriffsbeschränkungen und gelangte in Bereiche der Regierungsinfrastruktur, für die er keine Berechtigung hatte. Er konnte nicht öffentliche Dateien lesen und Dateien auf einem internen Server ablegen. Personenbezogene Medicare-Daten waren nach Angaben der australischen Regierung nicht betroffen. Der Agent war nicht mit einem Cyberangriff beauftragt worden. Er sollte Informationen recherchieren. Als der vorgesehene Zugriff nicht zum Ziel führte, veränderte er seine Strategie und überschritt dabei die Grenze zwischen Recherche und unautorisiertem Zugriff. OpenAI bezeichnet das als „misaligned behaviour“. Das System optimierte auf die Erfüllung seiner Aufgabe, behandelte die Zugriffsbeschränkung dabei aber offenbar nicht als verbindliche Grenze, sondern als Hindernis, für das sich ein anderer Weg finden ließ. Damit verschiebt sich ein Teil des Sicherheitsproblems. Die Schwachstellen selbst sind nicht neu. Neu ist, dass autonome Systeme sie finden, unterschiedliche Zugriffswege testen und einzelne Schritte zu einer funktionierenden Angriffskette verbinden können. Das australische Portal war ein jahrzehntealtes Legacy-System. Solche Systeme existieren in Behörden, Unternehmen und kritischen Infrastrukturen in großer Zahl. Ihre Verwundbarkeit wurde bisher auch dadurch begrenzt, dass das Auffinden und Ausnutzen von Schwachstellen Zeit, Fachwissen und Beharrlichkeit erforderte. Agentische Systeme senken diesen Aufwand. Sie können Oberflächen untersuchen, Ergebnisse bewerten, Sackgassen erkennen und Alternativen ausprobieren. Das skaliert nicht nur offensive Cybersecurity. Es verändert auch das Risiko bei vollkommen legitimen Aufgaben, sobald ein Agent genügend Handlungsspielraum und technische Werkzeuge erhält. Der australische Fall liefert dafür ein ziemlich konkretes Beispiel: Für einen unautorisierten Zugriff waren weder ein menschlicher Angreifer noch ein expliziter Angriffsbefehl notwendig. Es genügte ein Ziel, bei dessen Verfolgung das System selbst über den nächsten Schritt entscheiden konnte. Auch die Reaktion wirft Fragen auf. Der Zugriff erfolgte am 18. Juni. Services Australia wurde erst am 10. September informiert – 84 Tage später. Software, die selbstständig Lösungswege entwickelt, trifft damit auf Infrastrukturen, deren Sicherheitsmodelle weitgehend aus einer Zeit stammen, in der Software vorgegebene Abläufe ausführte. Das ist keine theoretische Risikoklasse mehr. In Australien hat sie gerade einen Praxistest bekommen. 🔗https://www.heise.de/news/OpenAI-Agent-knackt-australisches-Regierungsportal-11463920.html
Digitale Brieftasche: Sachverständige warnen vor Datenschutzproblemen
Ab Januar 2027 soll die deutsche EUDI-Wallet „d-you“ verfügbar sein. In der digitalen Brieftasche sollen Bürger Dokumente und Nachweise hinterlegen, sich gegenüber Behörden und Unternehmen ausweisen und beispielsweise Führerschein, Versicherungsnachweise oder andere digitale Identitätsdaten nutzen können. Grundlage ist die europäische eIDAS-Verordnung. Bei einer Anhörung im Bundestag haben Sachverständige nun Nachbesserungen am deutschen Digitale-Identitäten-Gesetz gefordert. Kritisiert wird unter anderem, dass biometrische Passbilder an Dienste übermittelt werden könnten, ohne dass eine ausdrückliche Einwilligung gesetzlich vorgeschrieben ist. Auch pseudonyme Nutzungsmöglichkeiten sind zum Start nicht vorgesehen. Ein weiteres Problem ist die mögliche „Überidentifizierung“: Unternehmen könnten mehr verifizierte Informationen aus der Wallet abfragen, als für einen konkreten Vorgang tatsächlich erforderlich sind. Ohne strengere Regeln für solche Datenabfragen drohe laut einer Sachverständigen ein „Cookie-Banner-2.0-Szenario“, bei dem Nutzer umfangreiche Freigaben aus Gewohnheit bestätigen. Der Zeitplan ist ambitioniert, bei einer Infrastruktur für digitale Identitäten sollte allerdings nicht der Veröffentlichungstermin über Datenschutz- und Sicherheitsfunktionen entscheiden. Ein Vertrauensverlust zum Start wäre wesentlich schwieriger zu korrigieren als eine Verzögerung um einige Monate. 🔗 https://digitalrechte.de/news/klappt-das-mit-der-digitalen-brieftasche
Wildberger will deutsche Tech-Produkte zur Marktreife bringen
Das Bundesdigitalministerium will mit dem neuen Programm „Digital Tech-to-Product“ Unternehmen dabei unterstützen, aus vorhandenen technologischen Entwicklungen tatsächlich marktfähige Produkte zu machen. Gefördert werden sollen insbesondere Start-ups und KMU, die Lösungen in Bereichen wie KI, Cybersicherheit, Datenökosysteme sowie Cloud- und Edge-Technologien entwickeln. Das klingt zunächst nach einem weiteren Förderprogramm in einer ohnehin schwer überschaubaren deutschen Förderlandschaft. Der Ansatz unterscheidet sich jedoch an einem wesentlichen Punkt: Finanziert werden soll nicht primär die nächste Forschungsphase, sondern der schwierige Übergang zwischen technologischer Entwicklung und kommerziell tragfähigem Produkt. Deutschland produziert seit Jahren hervorragende Forschungsergebnisse und verfügt über leistungsfähige Unternehmen, schafft es aber deutlich seltener, daraus international relevante Technologieanbieter entstehen zu lassen. Zwischen einem erfolgreichen Forschungsprojekt oder Prototyp und einem skalierbaren Produkt liegen Entwicklungsschritte, die teuer sind, unternehmerisches Risiko erzeugen und in vielen Fällen weder in die Logik klassischer Forschungsförderung noch in die Erwartungen privater Kapitalgeber passen. Genau an dieser Stelle öffentliche Förderung einzusetzen, ist industriepolitisch sinnvoll, weil technologische Souveränität nicht bereits dadurch entsteht, dass eine Technologie in Deutschland entwickelt wurde. Sie entsteht erst dann, wenn daraus Anbieter hervorgehen, deren Produkte dauerhaft weiterentwickelt werden, wirtschaftlich bestehen und in relevanter Größenordnung eingesetzt werden können. Allerdings endet das Problem nicht mit der Marktreife. Ein deutsches oder europäisches Unternehmen kann eine technisch konkurrenzfähige Cloud-, KI- oder Security-Lösung entwickeln und trotzdem daran scheitern, dass ihm Referenzkunden, große Aufträge und damit die Voraussetzungen für Skalierung fehlen. Gerade in Märkten, die von erheblichen Netzwerkeffekten, hohen Wechselkosten und dominierenden Plattformanbietern geprägt sind, entsteht Wettbewerb nicht automatisch dadurch, dass ein besseres Produkt verfügbar ist. Deshalb wird entscheidend sein, ob die Bundesregierung ihre Förderpolitik mit ihrer eigenen Beschaffungspolitik verbindet. Wenn der Staat einerseits Millionen investiert, um europäische Technologien bis zur Marktreife zu bringen, bei seinen eigenen IT-Projekten anschließend aber weiterhin Strukturen bevorzugt, die etablierte Anbieter und proprietäre Ökosysteme begünstigen, finanziert er Innovation, ohne ihr einen realistischen Weg in den Markt zu eröffnen. Dass das Digitalministerium den Staat stärker als Ankerkunden der heimischen Digitalwirtschaft positionieren und zugleich offene Schnittstellen, europäische Standards und Open Source stärken will, weist deshalb in die richtige Richtung. Die eigentliche Bewährungsprobe liegt jedoch nicht in Förderankündigungen, sondern in Vergabeverfahren, Architekturentscheidungen und langfristigen Beschaffungsstrategien. Deutschland hat kein Erkenntnisproblem darüber, wie wichtig eigene technologische Fähigkeiten sind. Es hat ein strukturelles Problem dabei, aus diesen Fähigkeiten Unternehmen entstehen zu lassen, die nach Ende der Förderung groß genug sind, um sich gegen internationale Plattformkonzerne zu behaupten. „Tech-to-Product“ kann diese Lücke verkleinern. Ob daraus auch „Product-to-Market“ und schließlich „Market-to-Scale“ wird, entscheidet sich allerdings an anderer Stelle. 🔗 https://www.heise.de/news/Souveraenitaet-Wildberger-foerdert-marktreife-Tech-Produkte-und-sichere-KI-11457136.html?utm_term=Autofeed&utm_medium=Social&utm_source=LinkedIn#Echobox=1789656867
DSGVO: Unternehmen klagen über hohen Aufwand – die Zahlen erzählen eine differenziertere Geschichte
Der Datenschutz bleibt für deutsche Unternehmen ein Reizthema. Laut aktueller Bitkom-Umfrage bewerten 92 Prozent den Aufwand als hoch, 90 Prozent wünschen sich eine Reform der DSGVO und 88 Prozent beklagen Rechtsunsicherheit. Ein Blick auf die vergangenen Jahre relativiert allerdings den Eindruck einer stetig wachsenden Belastung. 2024 bezeichneten 94 Prozent der Unternehmen den Datenschutzaufwand als hoch, 2025 waren es 97 Prozent. Auch beim Einsatz von KI hat sich wenig verändert: 2024 sahen 52 Prozent den Datenschutz als Hindernis, aktuell sind es 50 Prozent. Konkreter wird die Kritik dort, wo es um die Umsetzung geht. 76 Prozent wünschen sich eine einheitliche Auslegung durch die Datenschutzbehörden, 89 Prozent weniger Dokumentationspflichten bei risikoarmen Verarbeitungen und 73 Prozent mehr Rechtssicherheit bei Interessenabwägungen. Das spricht eher für ein Problem mit Bürokratie und Rechtsunsicherheit als für ein grundsätzlich zu hohes Datenschutzniveau. Interessant ist auch die andere Seite der Bilanz: 61 Prozent der Unternehmen geben an, dass die DSGVO ihre Datensicherheit verbessert habe. 42 Prozent haben aufgrund von Datenschutzbedenken bereits auf Produkte oder Lösungen aus Nicht-EU-Ländern verzichtet. Die Diskussion über eine Reform der DSGVO ist damit durchaus berechtigt. Weniger unnötige Dokumentation, konsistentere Aufsicht und klarere Regeln wären eine echte Entlastung. Daraus eine grundsätzliche Unvereinbarkeit von Datenschutz, Digitalisierung und KI abzuleiten, geben die Zahlen allerdings nicht her. 🔗 https://www.speicherguide.de/datenschutz/alle-jahre-wieder-bitkom-beklagt-auch-2026-den-datenschutz-27079.html
🗣️ Gastbeitrag
von Jens Decker JD Group
Edge Cloud beginnt im Netzwerk – warum Standort, Peering und Routing über die Performance entscheiden
Wer über Edge Cloud spricht, denkt meist zuerst an Rechenleistung: CPU, RAM, Storage, Kubernetes und möglichst kurze Entfernung zum Anwender. Das ist nachvollziehbar, greift technisch aber zu kurz. Denn eine Anwendung kann geografisch sehr nah am Nutzer betrieben werden und sich trotzdem langsam oder instabil anfühlen. Der Grund liegt häufig nicht im Compute-Layer, sondern im Netzwerk davor. Zwischen einem Endgerät und einer Edge-Anwendung liegen Access-Netze, Carrier, Internet Exchanges, Transitprovider und mehrere Routingentscheidungen. Erst ihr Zusammenspiel bestimmt, wie viele Umwege ein Datenpaket nimmt, wie stabil die Latenz bleibt und wie sich die Plattform bei einer Störung verhält. Eine leistungsfähige Edge Cloud beginnt deshalb nicht erst beim Server. Sie beginnt beim Netzwerk.
Geografische Nähe ist nicht automatisch Netzwerknähe
Ein Rechenzentrumsstandort in derselben Region ist zunächst ein guter Ausgangspunkt. Er garantiert aber noch keinen kurzen Netzwerkpfad. Entscheidend ist, wie der Internetprovider des Nutzers den Zielstandort erreicht. Fehlt ein geeignetes Peering, kann Traffic zunächst zu einem entfernten Übergabepunkt transportiert werden, dort den Carrier wechseln und anschließend wieder in die ursprüngliche Region zurücklaufen. Solche Umwege werden häufig als Hairpinning bezeichnet. Sie erhöhen nicht nur die Latenz, sondern auch die Zahl der beteiligten Netze und damit die Wahrscheinlichkeit von Engpässen oder Störungen. Für latenzkritische Workloads wie APIs, Datenbanken, virtuelle Desktops, Echtzeitkommunikation oder industrielle Anwendungen ist daher nicht allein die Entfernung auf der Landkarte relevant. Entscheidend ist die tatsächliche Topologie: Wo findet der Übergang zwischen den beteiligten Netzen statt, welche Alternativpfade existieren und wie stabil sind diese Pfade unter Last?
Peering bestimmt, wie direkt eine Edge Cloud erreichbar ist
Peering ist einer der wichtigsten Faktoren für die Qualität einer Edge-Plattform. Dabei tauschen zwei Netze ihren Traffic direkt miteinander aus, statt ihn über einen klassischen Transitprovider zu transportieren. Das kann über Route Server an einem Internet Exchange, über ein bilaterales Peering oder über einen Private Network Interconnect erfolgen. Je direkter dieser Austausch stattfindet, desto weniger externe Netze liegen zwischen Anwender und Plattform. Beim PoP Alsbach (ALS1) der ayedo Edge Cloud betrachten wir die Verbindung zur Interconnection-Infrastruktur deshalb als festen Bestandteil der Plattform. Über unser eigenes Providernetz AS204197 ist der PoP in einen standortübergreifenden MPLS-/EVPN-Backbone eingebunden und an die Frankfurter Peering-Landschaft angebunden. Dazu gehören unter anderem DE-CIX und LOCIX sowie mehrere voneinander unabhängige Transitpfade. Der Nutzen liegt dabei nicht darin, mit möglichst vielen Carrier- und Peering-Logos zu werben. Entscheidend ist, für relevante Zielnetze einen technisch sinnvollen und belastbaren Pfad anbieten zu können. Ein direkter oder gut gewählter Peering-Pfad kann Latenz und Jitter reduzieren, Transitabhängigkeiten verringern und bei Störungen zusätzliche Ausweichmöglichkeiten schaffen.
Routing ist kein Automatismus, sondern aktives Plattformdesign
BGP wird häufig so behandelt, als würde das Internet automatisch den besten Weg wählen. Das tut es nicht. BGP wählt einen zulässigen Pfad anhand definierter Richtlinien. Der kürzeste geografische oder schnellste Weg ist dabei keineswegs garantiert. Netzbetreiber beeinflussen diese Entscheidungen unter anderem über Local Preference, AS-Pfade, Communities und spezifische Präfixe. Damit lässt sich steuern, welche Upstreams oder Peerings bevorzugt werden, über welchen Standort Traffic ein- oder austreten soll und welche Ersatzwege im Fehlerfall zur Verfügung stehen. Gutes Routing beginnt daher mit einer klaren Policy. Peering-Pfade sollten sinnvoll priorisiert, Transitwege diversifiziert und Standortpräferenzen nachvollziehbar definiert werden. Ebenso wichtig sind saubere Prefix-Filter, RPKI-Validierung und IRR-basierte Prüfungen. Performance und Routing-Sicherheit sind keine getrennten Themen: Eine schnelle Route ist wertlos, wenn sie aufgrund einer Fehlankündigung oder eines Route Leaks in die falsche Richtung zeigt.
Resilienz entsteht nicht durch einen zweiten Port
Auch Redundanz wird im Marketing häufig zu einfach dargestellt. Zwei Leitungen oder zwei Router bedeuten noch keine hochverfügbare Architektur, wenn beide über dieselbe Trasse, denselben Carrier, dieselbe Stromversorgung oder denselben Übergabepunkt laufen. Echte Netzresilienz entsteht erst durch die Trennung der Failure Domains. Dazu gehören geografisch getrennte PoPs, unabhängige Carrier, alternative Glasfasertrassen, separate Router- und Strompfade sowie mehrere Interconnection- und Transitoptionen. Ebenso entscheidend ist, dass Failover nicht nur auf dem Papier existiert. Routingwechsel müssen regelmäßig getestet, Telemetriedaten zentral ausgewertet und Wiederanlaufszenarien automatisiert überprüft werden. Eine Ersatzroute, die im Störungsfall zwar aktiv wird, aber wegen MTU-Problemen, asymmetrischem Routing oder fehlenden Policies nur eingeschränkt funktioniert, ist keine belastbare Redundanz. Deshalb liegt ein Schwerpunkt unserer weiteren Netzentwicklung auf zusätzlichen carrier- und trassenunabhängigen Transportwegen, höheren Backbone-Kapazitäten und weiteren Interconnection-Standorten im DACH-Raum. Ziel ist nicht nur mehr Bandbreite, sondern eine Architektur, in der der Ausfall einzelner Leitungen, Carrier, Router oder Standorte möglichst ohne relevante Auswirkungen auf die bereitgestellten Dienste bleibt.
Kapazität muss dort verfügbar sein, wo sie gebraucht wird
Eine Edge-Plattform muss wachsen können, ohne dass jede Erweiterung einen grundlegenden Umbau auslöst. Dazu gehören skalierbare Übergaben, ausreichend Reserven im Backbone und die Möglichkeit, Kapazitäten an relevanten Standorten schnell zu erhöhen. 100-Gbit/s-fähige Infrastruktur ist dabei kein Selbstzweck. Entscheidend ist, Engpässe nicht nur am Serverport zu vermeiden, sondern entlang des gesamten Datenpfades: am Standort, auf dem Transportweg, an den Peering-Ports und bei den Upstreams. Gerade bei verteilten Cloud- und Kubernetes-Plattformen verschieben sich Traffic-Muster schnell. Replikation, Backups, Container-Images, Storage-Traffic und Kundenworkloads konkurrieren um dieselben Ressourcen. Ohne durchgängige Kapazitätsplanung kann eine Plattform lokal ausreichend dimensioniert sein und dennoch an einem schlecht ausgebauten Transport- oder Interconnection-Segment ausgebremst werden.
Edge Cloud ist das Zusammenspiel aus Compute und Netzwerk
Die technische Qualität einer Edge Cloud lässt sich nicht allein anhand von Prozessorgenerationen oder Storage-Performance bewerten. Sie zeigt sich im Zusammenspiel aus Compute, Standort, Transport, Peering, Routing, Sicherheit und Betriebsprozessen. Die Zusammenarbeit zwischen ayedo und der JD Group folgt genau diesem Ansatz: ayedo bringt die Cloud- und Plattformkompetenz ein, während wir die darunterliegende Provider- und Interconnection-Infrastruktur bereitstellen und weiterentwickeln. Für Kunden entsteht dadurch eine Plattform, die nicht nur regional verfügbar ist, sondern auch über kontrollierbare Netzwerkpfade, individuelle BGP- und Interconnect-Optionen sowie eine auf Resilienz ausgelegte Backbone-Architektur verfügt. Denn am Ende ist eine Edge-Anwendung nur so nah, schnell und verfügbar wie das Netzwerk, das sie mit ihren Nutzern verbindet.
☸️ Kubernetes-Updates
Kubernetes v1.37 härtet Container Storage
Mit Kubernetes 1.37 werden mehrere Sicherheitsmechanismen rund um persistenten Storage verschärft. Im Mittelpunkt stehen dabei insbesondere CSI-basierte Volumes und die Frage, welche Zugriffe Container auf eingebundene Speicherressourcen erhalten. Kubernetes setzt dafür stärker auf restriktive Mount-Konfigurationen und verbessert die Validierung sicherheitsrelevanter Optionen. Unter anderem sollen rekursive Read-only-Mounts verhindern, dass schreibgeschützte Volumes über darunterliegende Mountpoints dennoch verändert werden können. Auch der Umgang mit Mount-Optionen und Berechtigungen wird konsequenter abgesichert. Die Änderungen reduzieren damit Angriffsflächen an einer sensiblen Schnittstelle: Persistent Storage verbindet isolierte Container mit dauerhaft verfügbaren Daten und kann bei zu weitreichenden Berechtigungen zur Eskalation von Zugriffen beitragen. Für Betreiber lohnt sich beim Upgrade auf Kubernetes 1.37 deshalb ein genauer Blick auf bestehende Storage- und CSI-Konfigurationen – insbesondere dort, wo Anwendungen auf spezielle Mount-Optionen oder komplexe Volume-Strukturen angewiesen sind. 🔗 https://kubernetes.io/blog/2026/09/16/kubernetes-v1-37-hardening-container-storage/
📰 Short News
1. Wie unabhängig ist Europa wirklich von Big Tech?
Beim IONOS Summit 2026 zieht der „Digital Independence Day 10“ Bilanz: Wie weit ist Europa bei digitaler Souveränität tatsächlich gekommen, wo bestehen weiterhin kritische Abhängigkeiten und welche politischen Entscheidungen fehlen? Im Mittelpunkt stehen europäische Handlungsfähigkeit und die Frage, wie sich unabhängige digitale Infrastrukturen jenseits der großen US-Plattformanbieter etablieren lassen. 🔗 https://www.metacheles.de/so-unabhangig-sind-wir-von-big-tech-digital-independence-day-10-vom-ionos-summit-2026/
2. KI-Rechenzentren: Mehr Infrastruktur bedeutet nicht automatisch mehr Souveränität
Der massive Ausbau von Rechenzentren wird gerne als notwendige Voraussetzung für den KI-Standort Deutschland präsentiert. Der heise-Beitrag hinterfragt diese Logik und beleuchtet neben Energie- und Ressourcenbedarf auch die geopolitischen Abhängigkeiten, die durch einen Ausbau entstehen können, wenn zentrale Technologien und Plattformen weiterhin von wenigen internationalen Konzernen kontrolliert werden. 🔗 https://www.heise.de/hintergrund/KI-Hype-Warum-der-massive-Ausbau-von-Rechenzentren-kritisch-hinterfragt-wird-11410559.html
3. Siemens übernimmt Altair – und OpenRadioss verschwindet
Nach der Übernahme von Altair durch Siemens wurde das Open-Source-Projekt OpenRadioss offenbar aus dem öffentlichen Zugriff entfernt. Der Vorgang zeigt ein grundsätzliches Risiko von Open Source unter Unternehmenskontrolle: Eine offene Lizenz allein garantiert noch nicht, dass Entwicklung, Governance und öffentliche Verfügbarkeit eines Projekts langfristig erhalten bleiben. 🔗 https://www.golem.de/news/open-radioss-siemens-loescht-open-source-projekt-nach-uebernahme-2610-213724.html
4. Dänemark: Angreifer erhalten Zugriff auf Melderegister mit 8,8 Millionen Datensätzen
Über den Account eines privaten Dienstleisters konnten Angreifer auf Daten aus Dänemarks zentralem Personenregister CPR zugreifen. Betroffen sind nach Behördenangaben Informationen zu rund 8,8 Millionen Menschen. Der Vorfall zeigt erneut, dass die Sicherheit staatlicher Datenbestände nicht an der Grenze staatlicher IT endet, sondern sämtliche Dienstleister und deren Zugriffsrechte einschließen muss. 🔗 https://thehackernews.com/2026/10/denmark-says-attackers-accessed-cpr.html
5. Zu viele schlechte KI-Meldungen: Google beendet Open-Source-Bug-Bounty
Google stellt sein Open Source Software Vulnerability Rewards Program ein. Ein Grund ist offenbar die wachsende Zahl automatisiert erzeugter, qualitativ unzureichender Schwachstellenmeldungen durch KI-Systeme. Damit zeigt sich eine weniger diskutierte Folge generativer KI: Automatisierung erleichtert nicht nur die Suche nach Sicherheitslücken, sondern kann etablierte Sicherheitsprozesse durch massenhaft erzeugte Fehlmeldungen erheblich belasten. 🔗 https://www.golem.de/news/ungueltige-ki-einreichungen-google-stoppt-bug-bounty-programm-fuer-open-source-2610-213721.html
💚 In eigener Sache
Wir suchen die Hidden Champions europäischer Infrastruktur.
Für den Ausbau unserer ayedo Compute Cloud suchen wir gezielt mittelständische Hoster, regionale Carrier und spezialisierte Rechenzentrumsbetreiber in Deutschland und Europa. Denn gute Infrastruktur gibt es in Europa reichlich. Was vielen kleineren Providern fehlt, ist der Zugang zu den Endkunden, die heute bei den großen Cloud-Anbietern landen. Genau hier setzen wir an: Ihr betreibt Hardware, Virtualisierung, Netz und Rechenzentrum. Wir bringen Kubernetes-Plattform, Edge Cloud, Abrechnung, Endkunden-Portal und Support mit. Gemeinsam entsteht daraus ein verteiltes Netz unabhängiger europäischer Compute-Standorte. Dass dieses Prinzip funktioniert, haben wir bereits beim Aufbau unserer Edge Cloud erlebt. Über eine Markterkundung haben wir dort starke Partner und Standorte gefunden. Jetzt wollen wir diesen Ansatz auf die Compute Cloud übertragen. Unser Ziel: 100+ technisch unabhängige Standorte in Europa – statt noch mehr Abhängigkeit von wenigen Hyperscalern. Wer eigene Infrastruktur betreibt oder jemanden kennt, auf den das zutrifft: Unsere Markterkundung läuft. 🔗 https://ayedo.de/markterkundung-compute-cloud/
🚨 ALERT
GitHub-Ausfall trifft zentrale Entwicklungsprozesse
GitHub hatte am Montag mit erheblichen technischen Problemen zu kämpfen. Besonders betroffen waren GitHub Actions und die Hosted Runners, über die Unternehmen automatisiert Software bauen, testen und ausrollen. Zeitweise gab es zudem Einschränkungen bei Pages, Repository-Listen sowie Lizenzierungs- und Abrechnungsfunktionen. Die Störung traf damit nicht nur die Plattform selbst, sondern unmittelbar die Entwicklungsprozesse ihrer Kunden. In der intensivsten Phase schlugen laut GitHub 47 Prozent der Workflows auf GitHub-gehosteten Runnern fehl. Selbst betriebene Runner waren nicht betroffen. Als Ursache nennt GitHub einen teilweisen Netzwerkausfall, der die Verbindung zwischen einer eigenen Rechenzentrumsregion und Teilen der Cloud-basierten Datenbank- und Storage-Infrastruktur beeinträchtigte. Zur Stabilisierung musste Datenverkehr auf andere Regionen verlagert und zusätzliche Kapazität bereitgestellt werden. Der Vorfall zeigt, welche infrastrukturelle Bedeutung GitHub inzwischen erreicht hat. Die Plattform hostet längst nicht mehr nur Quellcode: Mit Actions, Runnern und weiteren Diensten ist sie tief in automatisierte Build-, Test- und Deployment-Prozesse integriert. Eine Störung kann deshalb Entwicklungs- und Release-Prozesse zahlreicher Unternehmen gleichzeitig beeinträchtigen. Dabei entsteht eine mehrstufige Abhängigkeit: Unternehmen verlagern zentrale Teile ihrer Softwareentwicklung zu GitHub, während GitHub für den Betrieb dieser Dienste seinerseits auf weitere Cloud-, Netzwerk- und Storage-Infrastrukturen angewiesen ist. Störungen auf einer Ebene können sich dadurch entlang der gesamten technischen Lieferkette fortsetzen. GitHub meldet seine Systeme inzwischen wieder als funktionsfähig und untersucht gemeinsam mit seinem Cloud-Provider Maßnahmen, um vergleichbare Ausfälle künftig besser abzufangen. 🔗https://www.heise.de/news/Ausfall-bei-GitHub-Actions-Pages-und-Abrechnung-gestoert-11476876.html?utm_term=Autofeed&utm_medium=Social&utm_source=LinkedIn#Echobox=1791238316
Meme der Woche